Hàm pandas Series dùng hằng ngày: map, apply, value_counts

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 11 phút đọc
Mục lục · 21
pandas Series là một cột dữ liệu có nhãn dòng, và phần lớn việc phân tích hằng ngày là gọi hàm pandas trên Series: đếm bằng value_counts, xem nhanh bằng describe, lọc bằng isin, đổi giá trị bằng map hay apply. Bài chạy từng hàm trên 6.000 đơn Tiệm Mây và đo apply chậm hơn cách vector hóa bao nhiêu lần trên 600.000 dòng.
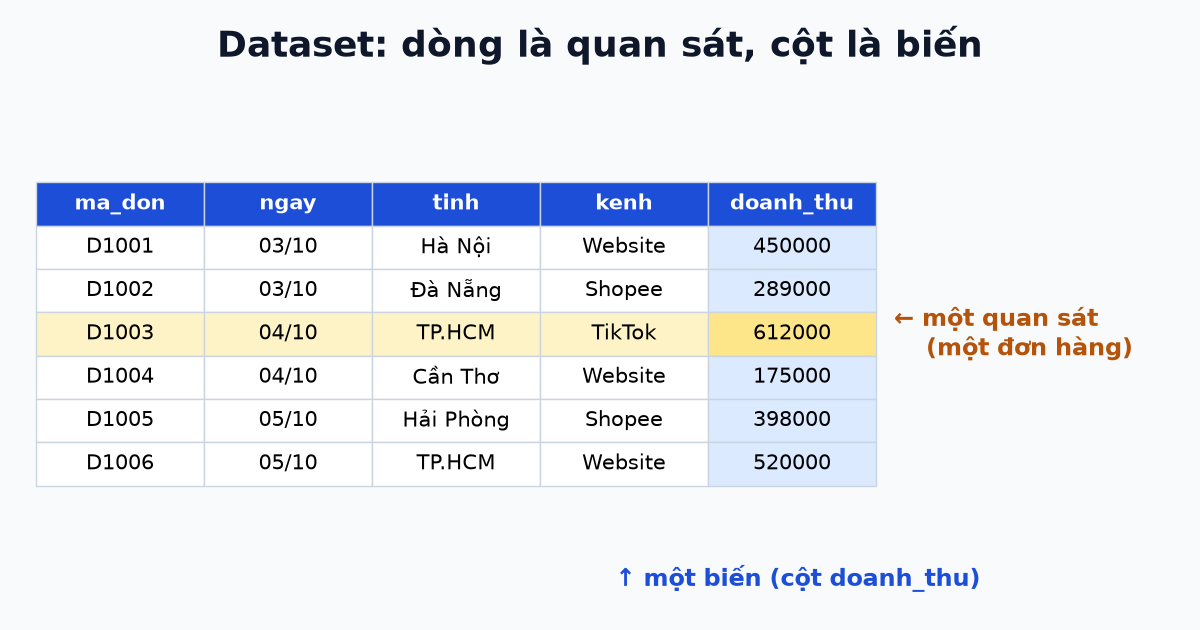
Trong pandas, Series là một cột dữ liệu một chiều có nhãn cho từng dòng; mỗi cột của DataFrame là một Series. Phần lớn việc phân tích hằng ngày là gọi hàm pandas trên Series: value_counts để đếm, describe để xem nhanh, isin và phép so sánh để lọc, map và apply để đổi giá trị. Trên 600.000 dòng đơn hàng, cách viết quyết định tốc độ: tính tiền từng dòng bằng apply(axis=1) mất 5,58 giây, viết thành phép tính trên cả cột chỉ mất 1,68 mili giây.
Mấy điều cần nắm trước khi đọc tiếp:
df["doanh_thu"](một cặp ngoặc) trả về Series;df[["doanh_thu"]](hai cặp ngoặc) trả về DataFrame một cột.mapnhận một dict hoặc một hàm và đổi từng giá trị; giá trị không có trong dict thành ô trốngNaN.applychạy một hàm Python cho từng phần tử. Nó dễ viết nhưng chậm, nên chỉ dùng khi không có lệnh nào tính trên cả cột.Dữ liệu là
don_hang_sach.csv(6.000 đơn) của cửa hàng mô phỏng "Tiệm Mây" ở lab.aidev.edu.vn/k2. Mọi lệnh chạy trên pandas 3.1.1, máy ảo AIDev Cloud, ngày 08/11/2026.
pandas Series là gì, khác DataFrame thế nào?
Series gồm hai phần: các giá trị cùng một kiểu (cột số lưu bằng mảng NumPy) và index (nhãn của từng dòng). DataFrame là nhiều Series chung một index, đặt cạnh nhau. Mình lấy cột doanh thu ra để xem:
import pandas as pd

df = pd.read_csv("https://lab.aidev.edu.vn/k2/du-lieu/don_hang_sach.csv", parse_dates=["ngay_dat"])
s = df["doanh_thu"]
print(type(s).__name__, s.dtype, len(s), s.name)
print(type(df[["doanh_thu"]]).__name__, df[["doanh_thu"]].shape)

Bạn cũng tạo được Series từ một list và tự đặt nhãn. Khi nhãn là mã đơn, bạn lấy giá trị theo mã bằng gia["DH000002"] (ra 929.000) hoặc theo vị trí bằng gia.iloc[0] (ra 619.000):
gia = pd.Series([619000, 929000, 2989000], index=["DH000001", "DH000002", "DH000003"], name="don_gia")
Khác biệt một hay hai cặp ngoặc quan trọng hơn vẻ ngoài: Series có những hàm DataFrame không có, như unique, between, .str, .dt. Bài pandas là gì giới thiệu DataFrame kỹ hơn; bài này tập trung vào những gì làm được trên một cột.
Những hàm pandas nào dùng nhiều nhất trên một cột?
Việc trên một cột thường chỉ cần một nhóm nhỏ hàm. Bảng dưới gom chúng theo việc, kèm kết quả trên 6.000 đơn để bạn hình dung:
Việc | Hàm | Kết quả trên |
|---|---|---|
Xem nhanh |
| 13 cột, 0 ô trống; trung vị đơn 929.000 đồng |
Đếm |
| Website 1.838 đơn; 8 danh mục |
Lọc |
| 5.129 đơn hoàn tất |
Sắp xếp |
| đơn lớn nhất 1.995.357.000 đồng |
Đổi giá trị |
| 3 mức đơn: nhỏ, vừa, lớn |
Chữ và ngày |
| doanh thu theo từng tháng |
Xuất ra ngoài |
| dict số đơn theo kênh |
Danh sách đầy đủ có trong tài liệu Series của pandas; phần còn lại của bài đi lần lượt từng nhóm.
Xem nhanh một cột bằng info và describe
Khi mở một bảng lạ, mình gọi df.info() trước để biết mỗi cột kiểu gì, có ô trống không, rồi describe() trên các cột số:
df.info()
print(s.describe())
print(s.describe().apply(lambda x: f"{x:,.0f}"))

describe in số kiểu 2.958915e+06 vì giá trị trong cột chênh nhau nhiều bậc (từ 49.000 đến gần 2 tỉ), nên pandas chuyển sang dạng khoa học. Định dạng lại bằng apply cho dễ đọc: trung bình 2.958.915 đồng nhưng trung vị chỉ 929.000 đồng. Khoảng cách lớn như vậy là dấu hiệu có vài đơn rất lớn kéo trung bình lên. Trên cột chữ như kenh, describe đổi sang đếm: 4 giá trị khác nhau, nhiều nhất là Website với 1.838 đơn.
Đếm và lọc: value_counts, isin, between
value_counts là hàm mình gọi nhiều nhất. Nó đếm mỗi giá trị xuất hiện bao nhiêu lần, xếp từ nhiều đến ít:
print(df["kenh"].value_counts())
print(df["trang_thai"].value_counts(normalize=True).round(3))

Thêm normalize=True thì ra tỉ lệ: 85,5% đơn hoàn tất, 8,5% bị hủy. nunique() đếm số giá trị khác nhau (8 danh mục), unique() liệt kê chúng.
Lọc trên Series bằng phép so sánh trả về một Series True/False cùng độ dài. Đưa Series đó vào df[...] để giữ các dòng True:
ht = df["trang_thai"] == "Hoàn tất"
print(ht.sum(), s[ht].sum())
print(df["kenh"].isin(["Website", "App"]).sum(), s.between(1_000_000, 3_000_000).sum())
print((ht & (df["kenh"] == "App")).sum())
Có 5.129 đơn hoàn tất, doanh thu 15.262.898.000 đồng. isin thay cho chuỗi == ... | == ... khi lọc nhiều giá trị (3.342 đơn Website hoặc App). between lọc khoảng, mặc định lấy cả hai đầu (1.668 đơn từ 1 đến 3 triệu). Ghép hai điều kiện phải dùng & và đặt mỗi điều kiện trong ngoặc: 1.300 đơn vừa hoàn tất vừa qua App. Mục "Lỗi mình gặp với Series" kể chuyện gì xảy ra khi viết and.
Để xem đơn lớn nhất, bạn gọi s.sort_values(ascending=False).head(3) hoặc df.nlargest(3, "doanh_thu"). Đơn đầu bảng là DH004429: 273 sản phẩm Điện tử, 1.995.357.000 đồng, chính là đơn kéo trung bình lên ở phần describe.
map và apply khác nhau thế nào?
map dùng khi bạn có sẵn bảng đổi giá trị, thường là một dict. Mình gom bốn kênh bán thành nhóm:
nhom = {"Website": "Trực tuyến", "App": "Trực tuyến", "Facebook": "Mạng xã hội"}
print(df["kenh"].map(nhom).value_counts(dropna=False))
print(df["kenh"].map(nhom).fillna("Khác").value_counts())

Dict thiếu "Sàn TMĐT", nên 1.494 đơn của kênh này thành NaN. map không báo lỗi khi thiếu khóa, vì vậy mình luôn gọi value_counts(dropna=False) sau map để thấy dòng NaN. Nếu chỉ muốn đổi vài giá trị và giữ nguyên phần còn lại, replace hợp hơn: df["kenh"].replace({"Sàn TMĐT": "San"}) giữ nguyên Website, App, Facebook.
apply dùng khi quy tắc đổi phức tạp hơn một bảng tra, ví dụ chia đơn theo giá trị:
def muc(x):
    if x >= 2_000_000: return "lớn"
    if x >= 500_000: return "vừa"
    return "nhỏ"
print(s.apply(muc).value_counts())
Kết quả: 2.297 đơn vừa, 1.870 đơn nhỏ, 1.833 đơn lớn. Cùng việc chia khoảng này, pd.cut(s, bins=[0, 500_000, 2_000_000, float("inf")], labels=["nhỏ", "vừa", "lớn"], right=False) cho đúng ba con số đó mà không cần viết hàm. right=False nghĩa là mỗi khoảng lấy đầu trái, khớp với dấu >= trong hàm muc.
.str và .dt cho cột chữ và cột ngày
Cột chữ có bộ hàm riêng sau .str: df["ma_sp"].str[2:] cắt bỏ chữ "SP", df["danh_muc"].str.upper() viết hoa, .str.contains("Mẹ") lọc theo chuỗi con. Cột ngày có .dt: df["ngay_dat"].dt.month lấy tháng, .dt.to_period("M") gom theo tháng để cộng doanh thu. Tháng 01/2025 có 1.499.330.000 đồng, gần gấp đôi tháng 02/2025 (767.378.000 đồng); dữ liệu mô phỏng này có đợt mua sắm trước Tết.
apply, map hay vector hóa: cách nào nhanh hơn?
Vector hóa là viết phép tính trên cả cột (s * 1.08) để pandas giao cho NumPy chạy bằng mã đã biên dịch, thay vì gọi hàm Python cho từng dòng. Mình đo chín cách viết cho bốn việc, trên 6.000 đơn và trên bảng chép lặp 100 lần (600.000 dòng); trong đó np.select của NumPy chọn nhãn theo một danh sách điều kiện, cùng việc với hàm muc. Mỗi cách chạy bảy lần ở bảng nhỏ, ba lần ở bảng lớn, lấy trung vị:
df["doanh_thu"].apply(lambda x: x * 1.08)          # apply
df["doanh_thu"] * 1.08                             # vector hóa
df.apply(lambda r: r["so_luong"] * r["don_gia"] - r["phi_van_chuyen"], axis=1)
df["so_luong"] * df["don_gia"] - df["phi_van_chuyen"]
Việc | Cách viết | 6.000 dòng | 600.000 dòng |
|---|---|---|---|
Tiền sau thuế 8% |
| 1,02 ms | 117,63 ms |
| 0,12 ms | 0,98 ms | |
Nhóm kênh |
| 0,96 ms | 71,15 ms |
| 0,73 ms | 29,92 ms | |
Mức đơn |
| 1,00 ms | 87,42 ms |
| 0,89 ms | 73,23 ms | |
| 0,66 ms | 9,31 ms | |
Tiền từng dòng, 3 cột |
| 54,89 ms | 5.578,31 ms |
phép tính trên cột | 0,27 ms | 1,68 ms |

Chênh lệch lớn nhất nằm ở apply(axis=1): mỗi dòng pandas phải dựng một Series mới rồi mới gọi hàm, nên 600.000 dòng mất 5,58 giây, chậm hơn phép tính trên cột khoảng 3.300 lần. Mình kiểm cả hai cho cùng kết quả từng dòng. Trên 6.000 dòng, hai cách chỉ mất 55 ms và 0,27 ms, đều quá nhanh để người dùng nhận ra. Vì vậy với file vài nghìn dòng, viết apply cho dễ đọc cũng không sao.
Mình bất ngờ khi thấy np.select gần bằng apply(muc) (73 so với 87 ms). Mình đoán phần lớn thời gian của cả hai nằm ở việc tạo 600.000 chuỗi "lớn", "vừa", "nhỏ". pd.cut nhanh gấp khoảng 9 lần apply(muc) vì nó lưu kết quả dạng category, mỗi dòng chỉ giữ một số nguyên trỏ tới nhãn. Bài NumPy là gì giải thích vì sao phép tính trên mảng cùng kiểu nhanh hơn vòng lặp Python.
Đổi Series sang list, dict, file CSV
Ba lệnh hay dùng khi đưa kết quả ra khỏi pandas:
print(df["kenh"].value_counts().to_dict())
print(s.head(3).to_list())
df["kenh"].value_counts().to_csv("dem_kenh.csv")
to_dict trả về {'Website': 1838, 'App': 1504, 'Sàn TMĐT': 1494, 'Facebook': 1164}, to_list trả về list Python thường. to_csv trên Series ghi cả index thành cột đầu: file dem_kenh.csv có tiêu đề kenh,count. Muốn chuyển một Series thành DataFrame để ghép tiếp, gọi s.to_frame() hoặc s.reset_index(); bài merge, join, concat trong pandas dùng các bảng như vậy để ghép.
Lỗi mình gặp với Series
The truth value of a Series is ambiguous
Mình viết điều kiện lọc theo thói quen Python:
df[ht and df["kenh"] == "App"]
ValueError: The truth value of a Series is ambiguous. Use a.empty, a.item(), a.any() or a.all().

and của Python cần một giá trị đúng hoặc sai duy nhất, còn ht là 6.000 giá trị. pandas không tự quyết được cả cột là đúng hay sai nên báo lỗi. Cách viết đúng là ht & (df["kenh"] == "App"), với | thay or và ~ thay not. Ngoặc quanh phép so sánh là bắt buộc, vì & được tính trước ==.
Lỗi truth value bên trong apply
Mình gặp lại thông báo này ở một chỗ không ngờ:
s.apply(lambda x: "lớn" if s >= 2_000_000 else "nhỏ")
Trong lambda mình gõ nhầm s (cả cột) thay vì x (một giá trị), nên if lại nhận 6.000 giá trị. Khi gặp lỗi "truth value of a Series" bên trong apply, hãy tìm xem biến nào trong hàm đang là cả Series.
map tạo NaN mà không báo lỗi
Như ở phần map, dict thiếu một khóa làm 1.494 đơn thành NaN mà không có thông báo nào. Lỗi kiểu này thường chỉ lộ ra khi cộng theo nhóm và thấy tổng nhỏ hơn tổng toàn bảng. Mình kiểm bằng .isna().sum() trên kết quả ngay sau mỗi lần map.
Khi nào không nên dùng apply?
Trong các hàm pandas ở bài này, apply là hàm mình cân nhắc lâu nhất trước khi dùng. Mình tránh nó trong ba trường hợp:
Khi có phép tính trên cột làm được cùng việc: cộng, nhân, so sánh,
np.where,pd.cut,.str,.dt. Gần như mọi tính toán trên cột số đều thuộc nhóm này.Khi chỉ cần đổi giá trị theo bảng tra: dùng
mapvới dict hoặcreplace.Khi phải chạy
apply(axis=1)trên bảng hàng trăm nghìn dòng: ở bảng đo 600.000 dòng, nó chậm hơn phép tính trên cột khoảng 3.300 lần.
apply vẫn hợp khi quy tắc có nhiều nhánh khó viết thành phép tính, bảng nhỏ, hoặc khi phải gọi một hàm bên ngoài cho từng giá trị, như chuẩn hóa một địa chỉ.
Câu hỏi thường gặp
Series và list Python khác nhau thế nào?
List chứa được nhiều kiểu lẫn lộn và không có nhãn. Series chứa một kiểu dữ liệu, có index, và tính được trên cả cột: s * 1.08 nhân mọi phần tử, còn list * 2 lặp list hai lần.
Làm sao chuyển Series thành list?
Gọi s.to_list() (hoặc s.tolist(), hai tên cùng một hàm). Kết quả là list Python với số kiểu int thường, dùng được ở mọi chỗ cần list.
map, apply và applymap khác nhau ra sao?
map và apply trên Series đổi từng giá trị. apply trên DataFrame chạy hàm theo cột hoặc theo dòng (axis=1). applymap bị đánh dấu sẽ bỏ từ pandas 2.1, thay bằng DataFrame.map, và không còn trong pandas 3. Mình gọi df.applymap(str) trên pandas 3.1.1 và nhận AttributeError: 'DataFrame' object has no attribute 'applymap'. Hãy dùng df.map.
Vì sao describe in số dạng e+06?
Khi cột có giá trị chênh nhau nhiều bậc, pandas chuyển sang dạng khoa học. Định dạng lại bằng s.describe().apply(lambda x: f"{x:,.0f}") như mục describe, hoặc đặt pd.set_option("display.float_format", "{:,.0f}".format) cho cả phiên làm việc.
Đọc tiếp
pandas là gì: DataFrame và 10 dòng code đầu tiên trên bộ dữ liệu Tiệm Mây.
NumPy là gì: mảng cùng kiểu đứng sau mỗi Series, và vì sao vector hóa nhanh.
merge, join, concat trong pandas: ghép bảng đơn hàng với khách hàng, sản phẩm, đếm dòng trước và sau.
Matplotlib là gì: vẽ 6 biểu đồ từ dữ liệu Tiệm Mây bằng matplotlib và seaborn, kèm cách sửa lỗi font tiếng Việt.
Ebook Phân tích dữ liệu với Python dạy các hàm trong bài này ở ba chương "Series, DataFrame và đọc ghi dữ liệu", "Chọn, lọc, sắp xếp" và "GroupBy, aggregation, map và apply"; riêng .str và .dt nằm ở hai chương "Làm sạch dữ liệu" và "Dữ liệu thời gian". Chương nào cũng có bài tập tự chấm. Nếu muốn học có đề cương và project được chấm, khóa Phân tích dữ liệu với Python là chặng thứ hai của lộ trình AI Engineer từ số 0.
Code chạy ngày 08/11/2026 trên máy ảo AIDev Cloud gói CPU Starter: Intel Xeon E5-2680 v4 8 vCPU, 15,6 GiB RAM, Ubuntu 24.04.4, Python 3.12.3, pandas 3.1.1, NumPy 2.5.4. Dữ liệu Tiệm Mây là dữ liệu mô phỏng của AIDev (giấy phép MIT).
Chuyên mục
Phân tích dữ liệu
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.