Dataset là gì? Cấu trúc, các loại và nơi tìm dữ liệu mẫu

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 8 phút đọc
Mục lục · 19
Dataset (bộ dữ liệu) là một tập dữ liệu được gom lại theo cùng một cấu trúc để phân tích hoặc huấn luyện mô hình. Bài giải thích dòng, cột, các loại dataset, ví dụ Việt Nam, cách kiểm tra trước khi dùng và nơi tìm dữ liệu mẫu.
Dataset (bộ dữ liệu, tập dữ liệu) là một tập hợp dữ liệu được gom lại theo cùng một cấu trúc để phục vụ một mục đích, như phân tích, làm báo cáo hay huấn luyện mô hình AI. Dạng quen thuộc nhất là một bảng: mỗi dòng là một đối tượng được ghi lại, mỗi cột là một thông tin về đối tượng đó.
Bài này giải thích một dataset gồm những phần nào, các loại dataset thường gặp, ví dụ gần gũi ở Việt Nam, những điều cần kiểm tra trước khi dùng, nơi tìm dữ liệu mẫu và cách mở dataset đầu tiên bằng Python.
Dataset là gì?
Lấy ví dụ file xuất đơn hàng của một shop bán mỹ phẩm online. Mỗi dòng là một đơn: mã đơn, ngày đặt, tỉnh nhận hàng, kênh bán, số tiền, trạng thái. Toàn bộ file đó là một dataset. Từ nó bạn có thể hỏi "tỉnh nào mua nhiều nhất", "tỷ lệ đơn hủy theo kênh là bao nhiêu", "tháng nào doanh thu cao nhất".
Một dataset khác với một mớ dữ liệu rời rạc ở chỗ nó có cấu trúc thống nhất: mọi dòng có cùng các cột, mỗi cột có cùng một kiểu (số, chữ, ngày tháng) và cùng một ý nghĩa. Nhờ vậy máy tính mới tính được trên cả bảng.
Dòng, cột và từ điển dữ liệu
Khi đọc tài liệu về dữ liệu, bạn sẽ gặp nhiều tên gọi cho cùng một thứ:
Thành phần | Tên gọi khác | Ví dụ trong bảng đơn hàng |
|---|---|---|
Dòng | quan sát, bản ghi, record, sample | một đơn hàng |
Cột | biến, thuộc tính, trường, feature |
|
Ô | giá trị |
|
Một dataset tử tế đi kèm từ điển dữ liệu (data dictionary): bảng mô tả từng cột nghĩa là gì, đơn vị là gì, giá trị nào được phép. Ví dụ cột doanh_thu tính bằng đồng hay nghìn đồng, đã trừ phí ship chưa. Thiếu từ điển dữ liệu là nguồn gốc của rất nhiều kết luận sai.
Các loại dataset thường gặp

Có cấu trúc và phi cấu trúc
Dữ liệu có cấu trúc: dạng bảng, như đơn hàng, bảng lương, điểm thi. Đây là loại người làm phân tích dữ liệu dùng nhiều nhất, thường lưu ở file CSV, Excel hoặc trong cơ sở dữ liệu.
Dữ liệu phi cấu trúc: văn bản, ảnh, âm thanh, video. Ví dụ tập bình luận đánh giá sản phẩm, tập ảnh biển số xe, tập ghi âm tổng đài. Muốn phân tích, thường phải biến chúng thành số trước.
Bán cấu trúc: JSON từ API, file log của máy chủ. Có khung nhưng không phẳng như bảng.
Chuỗi thời gian
Dataset mà mỗi dòng gắn với một thời điểm và thứ tự thời gian là quan trọng: giá vàng mỗi ngày, số đơn mỗi giờ, chỉ số bụi mịn theo giờ của một trạm quan trắc. Phân tích loại này cần thêm thao tác như gom theo tuần, theo tháng, tính trung bình trượt.
Dataset cho machine learning
Trong machine learning, dataset thường được chia ba phần: train để mô hình học, validation để chỉnh tham số và test để đánh giá lần cuối trên dữ liệu mô hình chưa thấy. Dataset còn được chia theo việc có nhãn hay không: tập ảnh đã ghi "chó" hoặc "mèo" cho từng ảnh là dataset có nhãn, dùng cho học có giám sát.

Ví dụ dataset gần gũi ở Việt Nam
Đơn hàng của một shop online: phân tích doanh thu theo tỉnh, theo kênh, tỷ lệ hoàn hàng.
Điểm thi của một trường: so sánh các lớp, xem phân phối điểm từng môn.
Giá nhà rao bán: diện tích, số phòng, quận, giá; dùng để tìm yếu tố ảnh hưởng đến giá.
Chi tiêu cá nhân: xuất từ ứng dụng ngân hàng, xem tiền đi đâu mỗi tháng.
Chất lượng không khí theo giờ: tìm khung giờ và mùa ô nhiễm cao.
Bài bộ dữ liệu trong tutorial Pandas của AIDev cung cấp các bộ dữ liệu tiếng Việt kiểu trên, do AIDev tự tạo bằng số giả lập nên dùng tự do và không chứa thông tin của người thật.
Kiểm tra gì trước khi dùng một dataset?
Tải được một file chưa có nghĩa là dùng được nó. Trước khi phân tích, hãy trả lời sáu câu:
Nguồn ở đâu, ai thu thập, thu thập thế nào? Khảo sát trên mạng xã hội và số liệu bán hàng thật cho hai bức tranh rất khác nhau.
Thời điểm nào? Giá nhà năm 2019 không mô tả được thị trường bây giờ.
Giấy phép cho phép dùng thế nào? Nhiều dataset chỉ cho dùng để học, không cho dùng thương mại.
Mỗi dòng là gì? Một đơn hàng hay một sản phẩm trong đơn? Nhầm chỗ này thì mọi phép đếm đều sai.
Thiếu, trùng, sai kiểu ra sao? Ô trống, dòng trùng, số lưu dạng chữ. Bài làm sạch dữ liệu với pandas đi qua từng lỗi.
Có dữ liệu cá nhân không? Họ tên, số điện thoại, địa chỉ gắn với một người cụ thể là dữ liệu cá nhân. Ở Việt Nam, việc xử lý loại dữ liệu này theo Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, Quốc hội thông qua ngày 26/06/2025 và có hiệu lực từ 01/01/2026 (Ngân hàng Nhà nước Việt Nam). Muốn chia sẻ hay đăng một dataset, hãy bỏ hoặc che các cột đó trước.
Tìm dataset miễn phí ở đâu?
Kaggle: cộng đồng khoa học dữ liệu có kho dataset rất lớn do người dùng đăng, kèm notebook mẫu và cuộc thi. Đọc kỹ giấy phép và phần mô tả của từng bộ, vì chất lượng không đồng đều.
UCI Machine Learning Repository: kho dataset lâu đời của Đại học California, Irvine, nhiều bộ kinh điển hay gặp trong giáo trình.
Thư viện Python: seaborn và scikit-learn có sẵn vài bộ dữ liệu nhỏ để luyện tập, tải bằng một dòng lệnh.
Nguồn nhà nước Việt Nam: Cục Thống kê (Bộ Tài chính) công bố số liệu kinh tế, xã hội như chỉ số giá tiêu dùng, dân số, lao động tại nso.gov.vn. Số liệu thường ở dạng bảng trong báo cáo, cần chép hoặc tải về rồi làm sạch trước khi phân tích.
Bộ dữ liệu tiếng Việt của AIDev: trang bộ dữ liệu, dùng ngay trong các bài tutorial mà không cần tải về.
Người mới nên bắt đầu với bộ dữ liệu nhỏ, cột dễ hiểu và có mô tả rõ. Một bảng vài nghìn dòng mà bạn hiểu từng cột dạy được nhiều hơn một bộ vài triệu dòng mà bạn không biết cột nào là gì.
Mở dataset đầu tiên bằng Python
Với dataset dạng bảng, pandas là thư viện Python dùng nhiều nhất. Ba dòng dưới đây đọc một file CSV và cho bạn biết bảng có bao nhiêu dòng, bao nhiêu cột, mỗi cột kiểu gì:
import pandas as pd

df = pd.read_csv("don_hang.csv")
print(df.shape)   # (số dòng, số cột)
df.info()         # tên cột, kiểu dữ liệu, số ô không trống
Đó là những lệnh đầu tiên người làm dữ liệu chạy với bất kỳ dataset mới nào. Lộ trình miễn phí của AIDev đi tiếp từ đây, mọi bài chạy code ngay trên trình duyệt:
NumPy: hiểu mảng số, thứ pandas dùng bên dưới mỗi cột.
Pandas: đọc CSV, Excel, lọc, gom nhóm, ghép bảng, làm sạch, bắt đầu từ trang bộ dữ liệu.
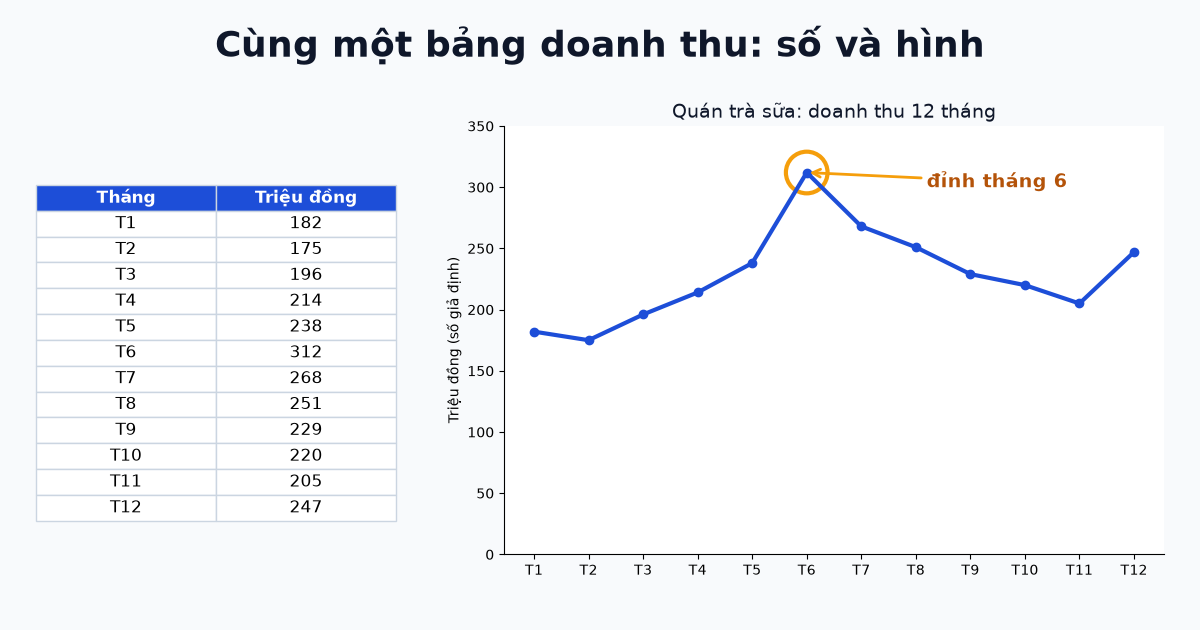
Matplotlib: vẽ biểu đồ từ bảng để nhìn ra điều mà con số giấu đi. Bài trực quan hóa dữ liệu là gì giải thích vì sao bước này quan trọng.
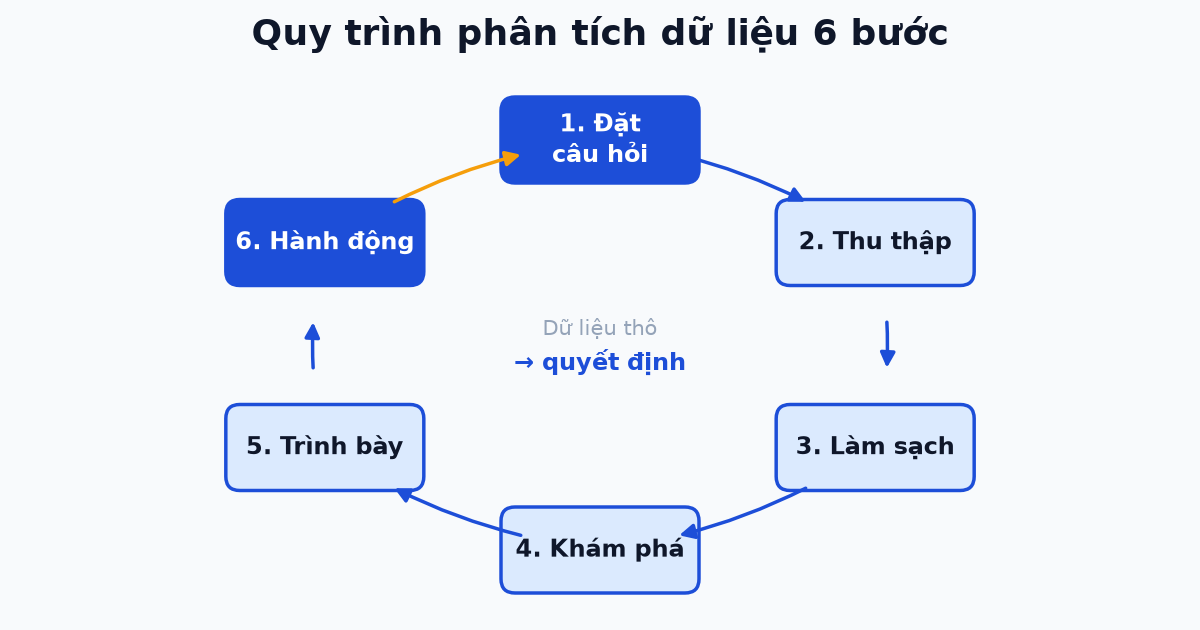
Toàn bộ quy trình từ đặt câu hỏi đến kết luận nằm trong bài data analysis là gì. Muốn biết làm Data Analyst cần học thêm những gì, xem bài Data Analyst cần học gì.
Câu hỏi thường gặp
Dataset và database khác nhau thế nào?
Database (cơ sở dữ liệu) là hệ thống lưu trữ và quản lý dữ liệu, cập nhật liên tục, nhiều người dùng cùng lúc. Dataset là một tập dữ liệu cụ thể, thường được trích ra từ database hoặc thu thập riêng cho một mục đích phân tích.
Data và dataset có giống nhau không?
Data là dữ liệu nói chung. Dataset là dữ liệu đã được gom và sắp theo một cấu trúc, đủ để đem đi phân tích.
Dataset cần bao nhiêu dòng là đủ?
Không có con số chung. Để học thao tác, vài trăm đến vài nghìn dòng là đủ. Để huấn luyện mô hình, số dòng cần thiết phụ thuộc vào bài toán và độ phức tạp của mô hình.
Kaggle là gì?
Kaggle là nền tảng cộng đồng khoa học dữ liệu, nơi người dùng chia sẻ dataset, notebook và tham gia cuộc thi machine learning. Đây là nơi nhiều người tìm dataset đầu tiên.
File CSV có phải là dataset không?
File CSV là một định dạng để lưu dataset dạng bảng, giống như Excel, JSON hay Parquet. Cùng một dataset có thể lưu ở nhiều định dạng.
Bước tiếp theo
Mở trang bộ dữ liệu, chọn một bộ bạn thấy gần với công việc của mình và chạy thử ba dòng code ở trên trong tutorial Pandas. Khi đã quen làm việc với dataset có sẵn và muốn làm trọn một dự án phân tích có người chữa bài, AIDev có khóa học có giảng viên đồng hành để bạn đi tiếp.
Chuyên mục
Phân tích dữ liệu
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.