Machine Learning là gì? Train model đầu tiên bằng Python

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 14 phút đọc
Mục lục · 18
Machine learning là gì? Nói ngắn, đó là cho máy học quy luật từ dữ liệu có sẵn đáp án. Bài này train một model dự đoán khách rời bỏ trên 10.787 khách của cửa hàng mô phỏng Tiệm Mây, so với baseline, đọc ma trận nhầm lẫn và bắt một lỗi rò rỉ dữ liệu đẩy điểm từ 0,781 lên 0,992.
Machine learning (học máy) là cách viết chương trình để máy tự tìm quy luật từ dữ liệu cũ, thay vì lập trình viên viết sẵn từng luật if…else. Bạn đưa cho máy nhiều ví dụ có sẵn đáp án, chẳng hạn lịch sử mua hàng của khách cùng thông tin khách đó có bỏ đi hay không. Máy học từ các ví dụ đó ra một model, rồi dùng model để đoán cho khách mới. Machine learning là một nhánh của AI (trí tuệ nhân tạo), và deep learning lại là một nhánh nhỏ hơn bên trong machine learning.
Để trả lời câu hỏi machine learning là gì bằng việc làm cụ thể, ngày 08/11/2026 mình train một model dự đoán khách rời bỏ trên máy CPU của AIDev Cloud. Mấy điều cần nắm trước khi đọc tiếp:
Dữ liệu có 10.787 khách của Tiệm Mây, một cửa hàng online mô phỏng, trong đó 18,1% khách bỏ đi.
Một "model" đoán mọi khách đều ở lại đã đúng 81,9%. Model thật phải thắng con số này mới đáng dùng.
Model đầu tiên là logistic regression, một model phân loại đơn giản. Model train trong 0,018 giây, đạt ROC-AUC 0,781 trên tập test (0,5 là đoán bừa). Tập test là phần khách để riêng, model không thấy lúc train.
Chỉ cần thêm một cột dữ liệu "nhìn thấy tương lai", điểm vọt lên 0,992. Đó là model hỏng, và cũng là lỗi người mới hay mắc.
Machine learning là gì, khác viết luật bằng tay thế nào?
Giả sử chủ cửa hàng muốn biết khách nào sắp bỏ đi để gửi mã giảm giá kịp lúc. Cách lập trình quen thuộc là ngồi nghĩ luật: "khách không mua 30 ngày thì coi như sắp bỏ". Luật này dễ hiểu, nhưng con số 30 là đoán. Luật đó cũng bỏ qua những thứ khác như khách hay bị giao trễ, khách khiếu nại nhiều.
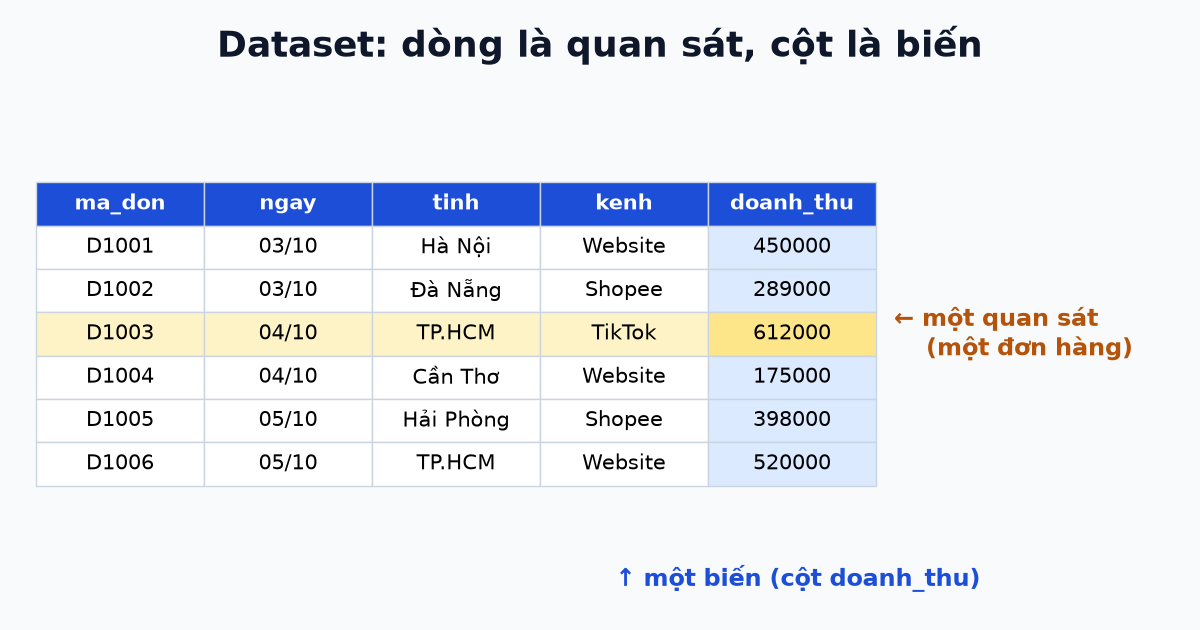
Với machine learning, bạn không viết luật. Bạn đưa cho máy một bảng, mỗi dòng là một khách, gồm các cột mô tả khách (gọi là feature) và một cột đáp án (gọi là label) ghi khách đó cuối cùng có bỏ đi không. Máy tự tìm cách kết hợp các feature sao cho đoán label đúng nhiều nhất. Kết quả của quá trình đó là model, một hàm nhận thông tin khách và trả về xác suất khách đó bỏ đi.
Việc "cho máy học" gọi là train (hay fit). Việc dùng model để đoán gọi là predict. Hai chữ này gần như có mặt trong mọi đoạn code machine learning bạn sẽ gặp.
Có những loại machine learning nào?
Cách chia hay gặp nhất dựa vào việc dữ liệu có sẵn đáp án hay không. Bảng dưới lấy ví dụ trong chính dữ liệu Tiệm Mây:
Loại | Dữ liệu train | Model trả lời câu hỏi | Ví dụ ở Tiệm Mây |
|---|---|---|---|
Học có giám sát (supervised), phân loại | có label dạng nhóm | thuộc nhóm nào? | khách này có rời bỏ không? |
Học có giám sát, hồi quy | có label là con số | bao nhiêu? | khách này sẽ chi bao nhiêu tiền quý tới? |
Học không giám sát (unsupervised) | không có label | các dòng tự chia thành nhóm nào? | chia khách thành nhóm theo thói quen mua |
Học tăng cường (reinforcement) | không có bảng sẵn, model tự thử và nhận điểm thưởng | làm gì tiếp theo? | ít gặp ở bài toán cửa hàng; hay dùng cho game, robot |
Phần lớn bài toán machine learning trong doanh nghiệp là học có giám sát trên dữ liệu bảng: dự đoán khách rời bỏ, chấm điểm hồ sơ vay, dự báo doanh số. Phần còn lại của bài đi qua đúng một bài toán phân loại như vậy, từ lúc đọc dữ liệu đến lúc bắt được lỗi.
Dữ liệu để train model trông như thế nào?
Mình dùng bộ dữ liệu "Tiệm Mây hai năm sau" trên AIDev Lab. Đây là dữ liệu mô phỏng, phát hành theo giấy phép MIT, không chứa thông tin người thật, cũng là bộ dữ liệu của sách và khóa Machine Learning của AIDev. Mỗi dòng là một khách hàng tại mốc 31/03/2026. Cột roi_bo bằng 1 nếu khách không mua đơn nào trong 90 ngày sau mốc.
Cài đúng bộ thư viện của khóa trong một môi trường ảo:
python3 -m venv ~/v && . ~/v/bin/activate
pip install -r https://lab.aidev.edu.vn/k3/requirements.txt
Trên máy CPU Starter của AIDev Cloud, lệnh pip install mất 7 phút 18 giây và cài scikit-learn 1.9.1, LightGBM 4.7.0, pandas 3.0.6, NumPy 2.5.4. Image Ubuntu 24.04 của máy chưa cài gói python3.12-venv, nên mình chạy apt-get install python3.12-venv trước khi tạo môi trường ảo.
Mọi script trong bài dùng chung một file chung.py để đọc dữ liệu và chia train/test giống nhau:
import pandas as pd
from sklearn.model_selection import train_test_split

URL = "https://lab.aidev.edu.vn/k3/du-lieu/"
COT = ["so_don", "tong_chi", "don_90_ngay_gan",
       "so_ngay_tu_lan_mua_cuoi", "so_danh_muc", "ti_le_huy",
       "so_lan_doi_tra", "so_lan_khieu_nai",
       "ti_le_dung_ma_giam", "ti_le_giao_tre", "nam_sinh"]

def doc(ten="khach_hang_churn.csv"):
    return pd.read_csv(URL + ten)

def chia(df, cot=COT):
    return train_test_split(df[cot], df["roi_bo"], test_size=0.2,
                            stratify=df["roi_bo"], random_state=42)
COT là 11 cột số ghi nhận trước mốc, dùng làm feature. Hàm chia để riêng 20% khách làm tập test. Model không được nhìn thấy tập này lúc train, nên điểm trên tập test cho biết model đoán khách mới tốt đến đâu. stratify giữ tỉ lệ khách rời bỏ ở hai phần bằng nhau, random_state=42 giúp lần chạy sau chia ra đúng như lần trước.
Xem nhanh dữ liệu bằng pandas:
from chung import doc, URL
import pandas as pd

khach = doc()
print(khach.shape)
print("tỉ lệ rời bỏ:", round(khach["roi_bo"].mean(), 3))
print(khach[["ma_kh", "so_don", "tong_chi", "so_ngay_tu_lan_mua_cuoi", "roi_bo"]].head(5).to_string(index=False))
mo_ta = pd.read_csv(URL + "mo_ta_cot.csv")
print(mo_ta[mo_ta["ghi_nhan"] == "sau mốc"].to_string(index=False))

Hai dòng cuối của output đáng để ý: file mô tả cột ghi rõ hai cột được ghi nhận sau mốc dự đoán. Một cột là label roi_bo. Cột còn lại, số lần khách liên hệ chăm sóc khách hàng trong 90 ngày sau mốc, sẽ xuất hiện lại ở phần rò rỉ dữ liệu.
Model đầu tiên phải thắng được ai?
Trước khi train model thật, mình cần một mốc để so, gọi là baseline. Baseline đơn giản nhất cho bài phân loại là luôn đoán nhóm đông nhất. Ở đây là đoán mọi khách đều ở lại.
from chung import doc, chia
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score, recall_score, roc_auc_score

X_train, X_test, y_train, y_test = chia(doc())
print("train:", X_train.shape, "test:", X_test.shape)
dummy = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
du = dummy.predict(X_test)
print("baseline đoán mọi khách ở lại")
print("  accuracy:", round(accuracy_score(y_test, du), 3))
print("  recall (bắt được bao nhiêu khách rời bỏ):", round(recall_score(y_test, du), 3))
print("  ROC-AUC:", round(roc_auc_score(y_test, dummy.predict_proba(X_test)[:, 1]), 3))

Accuracy (tỉ lệ đoán đúng) 81,9% nghe có vẻ tốt, nhưng model này không bắt được khách rời bỏ nào: recall bằng 0. Đây là lý do người làm machine learning ít khi chỉ nhìn accuracy khi một nhóm chiếm phần lớn dữ liệu. Ba thước đo mình dùng trong bài:
Recall: trong số khách thật sự bỏ đi, model bắt được bao nhiêu phần.
Precision: trong số khách model báo sẽ bỏ đi, bao nhiêu phần báo đúng.
ROC-AUC: model xếp khách sắp bỏ lên trên khách ở lại giỏi đến đâu, không phụ thuộc ngưỡng. 0,5 là đoán bừa, 1 là xếp đúng hoàn toàn.
Train model machine learning đầu tiên bằng scikit-learn
Model đầu tiên là logistic regression, một model phân loại đơn giản có sẵn trong scikit-learn. Các cột có thang đo rất khác nhau (tổng chi lên tới hàng triệu đồng, tỉ lệ hủy đơn từ 0 đến 1), nên mình đặt StandardScaler trước model để đưa các cột về cùng thang. make_pipeline ghép hai bước thành một khối, gọi fit một lần là xong cả hai.
import time
from chung import doc, chia
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, recall_score, precision_score, roc_auc_score, confusion_matrix
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X_train, X_test, y_train, y_test = chia(doc())
model = make_pipeline(StandardScaler(), LogisticRegression(random_state=42))
t = time.perf_counter()
model.fit(X_train, y_train)
print(f"fit {len(X_train)} khách mất {time.perf_counter() - t:.3f} giây")
du = model.predict(X_test)
xs = model.predict_proba(X_test)[:, 1]
print("accuracy:", round(accuracy_score(y_test, du), 3))
print("precision:", round(precision_score(y_test, du), 3))
print("recall:", round(recall_score(y_test, du), 3))
print("ROC-AUC:", round(roc_auc_score(y_test, xs), 3))
print("ma trận nhầm lẫn [[ở lại đúng, báo nhầm], [bỏ sót, bắt đúng]]:")
print(confusion_matrix(y_test, du))
bang = X_test.head(3)[["so_don", "don_90_ngay_gan", "so_ngay_tu_lan_mua_cuoi"]].copy()
bang["xac_suat_roi_bo"] = xs[:3].round(3)
bang["thuc_te"] = y_test.head(3).values
print(bang.to_string(index=False))

Model train 8.629 khách trong 0,018 giây. Kết quả trên 2.158 khách của tập test:
Thước đo | Baseline | Logistic regression |
|---|---|---|
Accuracy | 0,819 | 0,828 |
Recall | 0 | 0,279 |
Precision | không tính được | 0,551 |
ROC-AUC | 0,5 | 0,781 |
Ma trận nhầm lẫn kể chi tiết hơn. Tập test có 391 khách bỏ đi thật. Model bắt đúng 109 khách, bỏ sót 282 khách, và báo nhầm 89 khách đang ở lại. Recall 0,279 nghĩa là ở ngưỡng mặc định 0,5 (model báo "bỏ đi" khi xác suất vượt 0,5), cứ 10 khách sắp bỏ đi thì model chỉ bắt được chưa tới 3.
Con số này không có nghĩa model vô dụng. ROC-AUC 0,781 cho thấy model xếp hạng khách khá tốt, chỉ là ngưỡng 0,5 quá cao với bài toán mà khách rời bỏ chỉ chiếm 18,1%. Hạ ngưỡng xuống thì bắt được nhiều khách hơn, đổi lại báo nhầm nhiều hơn. Chọn ngưỡng bao nhiêu là bài toán tiền: một mã giảm giá gửi nhầm tốn bao nhiêu, một khách mất đi thiệt bao nhiêu.
Data leakage: vì sao model đạt 0,992 lại là model hỏng?
Data leakage (rò rỉ dữ liệu) là khi model được train trên thông tin mà lúc dùng thật không thể có. Bộ dữ liệu Tiệm Mây cố ý giữ một cột như vậy: so_lan_lien_he_cskh_sau_moc, số lần khách liên hệ chăm sóc khách hàng trong 90 ngày sau mốc. Mình thêm cột đó vào và train lại:
from chung import doc, chia, COT
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

khach = doc()
for ten, cot in [("11 cột ghi trước mốc", COT),
                 ("+ so_lan_lien_he_cskh_sau_moc", COT + ["so_lan_lien_he_cskh_sau_moc"])]:
    X_train, X_test, y_train, y_test = chia(khach, cot)
    m = make_pipeline(StandardScaler(), LogisticRegression(random_state=42)).fit(X_train, y_train)
    print(f"{ten:<32} ROC-AUC test {roc_auc_score(y_test, m.predict_proba(X_test)[:, 1]):.3f}")

print("# một cột đứng riêng đoán được bao nhiêu (ROC-AUC, lấy max(auc, 1-auc))")
kq = []
for c in COT + ["so_lan_lien_he_cskh_sau_moc"]:
    a = roc_auc_score(khach["roi_bo"], khach[c])
    kq.append((max(a, 1 - a), c))
for a, c in sorted(kq, reverse=True)[:4]:
    print(f"{c:<30} {a:.3f}")

ROC-AUC tăng từ 0,781 lên 0,992. Nếu chỉ nhìn số, đây là model gần như hoàn hảo. Nhưng vào ngày 31/03, không ai biết khách sẽ gọi chăm sóc khách hàng bao nhiêu lần trong ba tháng tới. Đem model này ra dùng thật, cột đó luôn trống hoặc sai, và điểm 0,992 không còn ý nghĩa.

Cách mình bắt lỗi này nằm ở nửa dưới của output: tính ROC-AUC của từng cột khi đứng một mình. Một cột đơn lẻ đạt 0,980, trong khi cột thật tốt nhất (số ngày từ lần mua cuối) chỉ đạt 0,777. Khi một cột tốt bất thường như vậy, mình mở mô tả cột ra đọc trước khi tin nó. Tài liệu scikit-learn về các lỗi hay gặp mô tả thêm một dạng rò rỉ khác, xảy ra khi bạn scale hoặc chọn feature trên toàn bộ dữ liệu trước khi chia train/test. Đặt mọi bước tiền xử lý vào pipeline như ở trên là cách tránh dạng rò rỉ đó.
Lỗi hay gặp khi fit model lần đầu
Hai lỗi dưới đây xảy ra khi mình bỏ qua bước chọn cột và đưa gần như cả bảng vào model.
from chung import doc
from sklearn.linear_model import LogisticRegression

khach = doc()
X = khach.drop(columns=["ma_kh", "roi_bo", "so_lan_lien_he_cskh_sau_moc"])
y = khach["roi_bo"]
for ten, XX in [("đưa cả bảng vào model", X),
                ("chỉ cột số, còn ô trống", X.select_dtypes("number"))]:
    print("#", ten)
    try:
        LogisticRegression().fit(XX, y)
    except ValueError as e:
        print("ValueError:", str(e).splitlines()[0])
print("ô trống ở diem_danh_gia_tb:", X["diem_danh_gia_tb"].isna().sum())

Lỗi 1:
ValueError: could not convert string to float: '2025-02-10'
Model của scikit-learn chỉ nhận số. Cột ngay_dang_ky là ngày dạng chữ, các cột tinh, kenh_chinh, hang_thanh_vien cũng là chữ. Cách sửa là chọn cột số, hoặc đổi cột chữ thành số bằng OneHotEncoder và đổi ngày thành số ngày đã qua.
Lỗi 2:
ValueError: Input X contains NaN.
Đã bỏ cột chữ nhưng cột diem_danh_gia_tb (điểm đánh giá trung bình) còn 1.345 ô trống, vì nhiều khách chưa bao giờ đánh giá. Logistic regression không nhận ô trống. Cách sửa là bỏ cột đó như mình làm ở trên, hoặc thêm SimpleImputer vào pipeline để điền giá trị. Điền thế nào cũng là một quyết định: khách chưa đánh giá khác khách đánh giá trung bình.
Học machine learning cần biết gì trước?
Hiểu machine learning là gì qua một bài toán rồi, bạn sẽ thấy ba thứ nên có trước khi học sâu hơn:
Python cơ bản: biến, list, hàm, vòng lặp, đọc file.
pandas và NumPy: đọc bảng, lọc, nhóm, xử lý ô trống. Cả hai lỗi ở phần trên đều nằm ở dữ liệu. Bài NumPy là gì giải thích mảng số, dạng dữ liệu mà model nào cũng nhận vào.
Thống kê nền: trung bình, phân phối, xác suất có điều kiện. Bạn không cần toán đại học để train model đầu tiên, nhưng cần đủ để hiểu vì sao accuracy 81,9% có thể vô nghĩa.
Nếu bạn đang phân vân giữa nghề dữ liệu và nghề AI, bài Data Analyst, Data Scientist và AI Engineer khác nhau ở đâu so ba nghề cạnh nhau. Người làm machine learning hằng ngày thường mang chức danh ML Engineer, công việc của họ được mô tả trong bài Machine Learning Engineer là gì qua 29 tin tuyển dụng.
Muốn học bài bản thì Khóa 3 Machine Learning thực chiến của lộ trình AIDev dùng đúng bộ dữ liệu Tiệm Mây trong bài này. Khóa đi từ baseline, chống data leakage bằng pipeline, chọn ngưỡng theo tiền đến giải thích model bằng SHAP (công cụ cho biết vì sao model đoán như vậy), có bộ chấm tự động cho từng notebook. Nếu thích đọc, ebook Machine Learning thực chiến đang bán, có bài tự chấm chạy trên chính các file dữ liệu này. Nếu đang so nhiều khóa, bài khóa học machine learning chỉ cách kiểm một khóa có dạy chống data leakage và có chấm bài hay không.
Khi nào không nên dùng machine learning?
Machine learning không phải lúc nào cũng là lựa chọn đúng. Mình sẽ không dùng nó khi:
Luật đã rõ và ít khi đổi. Tính phí ship theo cân nặng, kiểm tra mã số thuế đủ 10 số: viết
if…elsenhanh hơn, dễ kiểm tra hơn.Không có label. Muốn dự đoán khách rời bỏ thì phải có lịch sử ghi lại khách nào đã rời bỏ. Chưa có thì việc đầu tiên là ghi dữ liệu, chưa phải train model.
Dữ liệu quá ít. Vài chục dòng thì model chỉ học thuộc. Bài này có 10.787 khách: để riêng 2.158 khách làm tập test, phần train vẫn còn 8.629 khách.
Sai một lần là quá đắt và cần giải thích từng quyết định. Khi đó model chỉ nên là công cụ gợi ý cho người quyết định.
Câu hỏi thường gặp
Machine learning dịch là gì?
Machine learning dịch là "học máy": máy tính học từ dữ liệu. Trong tài liệu và tin tuyển dụng ở Việt Nam, người ta dùng nguyên chữ tiếng Anh nhiều hơn, viết tắt là ML.
Machine learning và AI khác nhau thế nào?
AI là tên chung cho mọi cách giúp máy làm việc vốn cần trí thông minh, kể cả một bộ luật viết tay. Machine learning là nhánh của AI trong đó máy tự học luật từ dữ liệu. Deep learning là nhánh của machine learning dùng mạng nơ-ron nhiều lớp, đứng sau nhận diện ảnh, giọng nói và LLM (mô hình ngôn ngữ lớn) như GPT. Bài machine learning và deep learning khác nhau thế nào giải cùng bài toán khách rời bỏ bằng cả ba cách rồi so điểm và thời gian train.
Có những loại machine learning nào?
Ba loại chính là học có giám sát (dữ liệu có đáp án, gồm phân loại và hồi quy), học không giám sát (không có đáp án, máy tự chia nhóm) và học tăng cường (máy tự thử và nhận điểm thưởng). Bài toán doanh nghiệp phần lớn là học có giám sát trên dữ liệu bảng.
Có sách machine learning tiếng Việt không?
Có. AIDev có ebook Machine Learning thực chiến viết bằng tiếng Việt, dạy scikit-learn, LightGBM và SHAP trên dữ liệu Tiệm Mây, kèm bài tập tự chấm. Thuật ngữ chuẩn ngành như model, feature, label được giữ tiếng Anh và giải thích ở lần đầu.
Học machine learning dùng thư viện gì?
Với dữ liệu bảng, scikit-learn là thư viện chính, cộng thêm LightGBM hoặc XGBoost khi cần model mạnh hơn. Khi sang ảnh, văn bản và mạng nơ-ron lớn thì dùng PyTorch.
Đọc tiếp
Lộ trình AI Engineer: học gì, theo thứ tự nào: machine learning nằm ở chặng thứ ba của lộ trình năm chặng.
Machine Learning Engineer là gì: nghề train và vận hành model.
NumPy là gì: mảng số mà mọi model scikit-learn nhận vào.
Code trong bài chạy trên máy CPU Starter của AIDev Cloud (8 vCPU, Ubuntu 24.04, Python 3.12.3, scikit-learn 1.9.1, pandas 3.0.6), ngày 08/11/2026. Dữ liệu Tiệm Mây là dữ liệu mô phỏng, giấy phép MIT.
Chuyên mục
Machine Learning
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.