Lộ trình AI Engineer: học gì, theo thứ tự nào, mất bao lâu
AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 14 phút đọc4 lượt xem
Mục lục · 22
Lộ trình AI Engineer gồm 5 chặng nối nhau: Python, phân tích dữ liệu, machine learning, deep learning, rồi ứng dụng LLM và AI agent. Bài này nói mỗi chặng học gì, học đến đâu thì sang chặng sau, mất bao lâu, đối chiếu với 35 tin tuyển dụng AI Engineer ngày 11/10/2026.
Lộ trình AI Engineer cho người mới có 5 chặng, đi theo thứ tự: Python, phân tích dữ liệu, machine learning, deep learning, rồi ứng dụng LLM và AI agent. Học đều 10 đến 12 giờ mỗi tuần thì mất khoảng 7 đến 9 tháng. Đi hết, thứ bạn có trong tay là vài sản phẩm chạy được, có link để người khác bấm vào dùng thử.
Đây là thứ tự AIDev dùng khi soạn đề cương 32 chương cho lộ trình của mình. Trước khi viết bài này, mình đọc thêm 35 tin tuyển dụng AI Engineer trên ITviec, TopCV và LinkedIn để xem doanh nghiệp đang đòi gì, và kết quả khớp với thứ tự đó. Ở mỗi chặng mình để một đoạn code ngắn đã chạy thử, để bạn hình dung học xong chặng đó thì làm được gì.
Vì sao lộ trình AI Engineer bắt đầu từ Python?
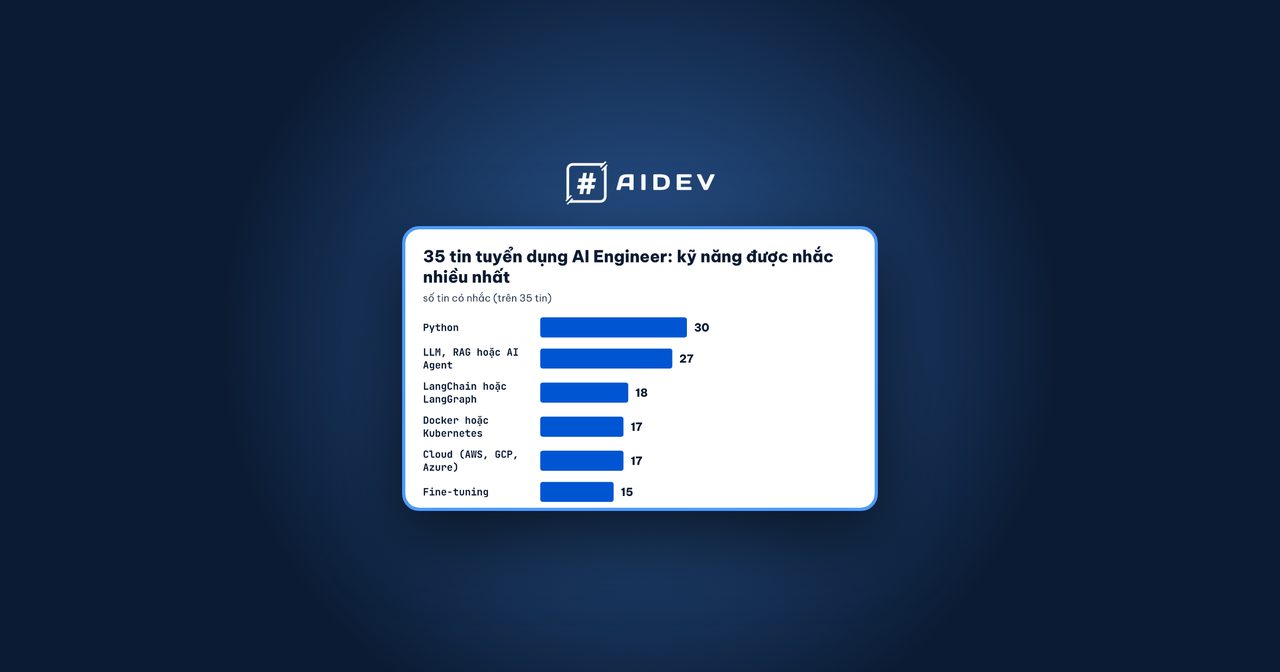
AI Engineer là người xây ứng dụng trên các model AI có sẵn rồi đưa ứng dụng đó lên chạy thật. Bài AI Engineer là gì nói kỹ hơn về nghề này. Ở đây chỉ cần nhìn một biểu đồ, đếm từ 35 tin tuyển dụng ngày 11/10/2026:

Python có mặt trong 30 tin, nhiều hơn mọi kỹ năng khác. Những thứ xếp sau như LangChain hay PyTorch cũng chủ yếu dùng qua Python. Đứng thứ hai là LLM, RAG hoặc AI agent (27 tin), tức phần việc của chặng cuối.
Vậy sao không học thẳng phần LLM cho nhanh? Vì khi một chatbot RAG trả lời sai, lỗi có thể nằm ở dữ liệu đầu vào, ở bước tìm tài liệu, hoặc ở chính model. Muốn biết nó nằm ở đâu, bạn phải hiểu dữ liệu và hiểu model học thế nào. Bốn chặng đầu dạy đúng phần đó.
5 chặng, mỗi chặng ra một sản phẩm
Chặng | Học gì | Project cuối chặng | Giờ video (đề cương AIDev) |
|---|---|---|---|
1. Python | Cú pháp, cấu trúc dữ liệu, hàm, OOP, Git | App dòng lệnh quản lý chi tiêu | ~18,7 |
2. Phân tích dữ liệu | NumPy, pandas, trực quan hóa, thu thập dữ liệu, thống kê | Báo cáo EDA trên dữ liệu Việt Nam | ~29 |
3. Machine Learning | scikit-learn, hồi quy, phân loại, feature engineering | Dự đoán khách hàng rời bỏ (churn) | ~18,5 |
4. Deep Learning & GenAI | PyTorch, computer vision, NLP, Transformer, LLM | App AI nhỏ: RAG hoặc phân loại ảnh | ~20,8 |
5. Ứng dụng LLM & AI Agent | RAG production, agent, MCP, evals, deploy | Ứng dụng AI có RAG hoặc agent, đo bằng 50 câu evals | ~28,1 |
Ngoài 5 project trên còn một dự án cuối khóa, bạn tự chọn đề tài. Bản đồ một trang dưới đây gom cả lộ trình lại:

Bạn không nhất thiết phải đi hết mới đi làm. Có hai chỗ dừng hợp lý. Xong chặng 2 hoặc 3 là đủ nền để thử các vị trí dữ liệu như Data Analyst. Xong chặng 5 cùng dự án cuối khóa thì nhắm tới AI Engineer, LLM Engineer.
Chặng 1: Python
Bạn học biến, vòng lặp, hàm, list, dict, đọc ghi file, xử lý lỗi, lập trình hướng đối tượng và Git. Chặng này xong khi bạn tự viết được một chương trình nhỏ cho một việc có thật mà không chép code mẫu. Chẳng hạn gom chi tiêu trong tuần theo từng mục rồi xếp từ nhiều đến ít:
chi_tieu = [
    ("ăn uống", 45000), ("đi lại", 30000), ("ăn uống", 60000),
    ("học tập", 199000), ("đi lại", 25000),
]
tong = {}
for muc, tien in chi_tieu:
    tong[muc] = tong.get(muc, 0) + tien
for muc, tien in sorted(tong.items(), key=lambda x: -x[1]):
    print(f"{muc:<10}{tien:>10,} đ")

Chục dòng này đã dùng gần đủ những thứ cơ bản: list, tuple, dict, vòng lặp, sorted với lambda, f-string. Đọc thấy hiểu ngay và tự viết được một chương trình tương tự cho việc của mình thì chặng 1 coi như ổn.
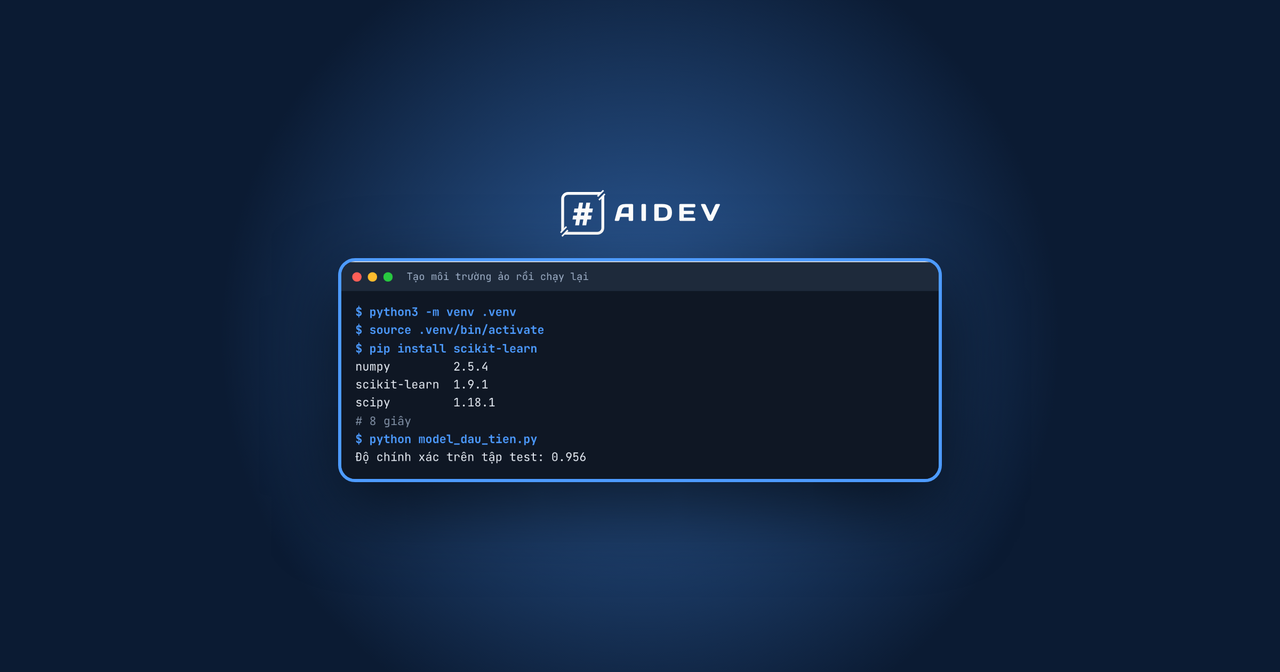
Trước cả dòng code đầu tiên, việc của tuần đầu thường là cài Python, làm quen với terminal và tạo môi trường ảo (venv). Nghe đơn giản, nhưng lỗi lúc cài đặt thường khó đọc hơn lỗi trong code, người mới dễ kẹt ở đây. Bài tự học AI có phần cài đặt từng bước.
Chặng 2: Phân tích dữ liệu với pandas
Bạn học NumPy, pandas, vẽ biểu đồ, lấy dữ liệu từ file, API, web và SQL, thêm một ít thống kê để khỏi kết luận sai. Chặng này xong khi bạn nhận một file dữ liệu thô, tự làm sạch, rồi trả lời được một câu hỏi bằng con số.
Ví dụ gần nhất là chính biểu đồ ở đầu bài. Để đếm xem 35 tin tuyển dụng nhắc kỹ năng nào nhiều nhất, mình viết đoạn pandas này:
import pandas as pd

df = pd.read_csv("tin_tuyen_dung.csv")
ky_nang = (df["yeu_cau_ky_nang"].str.split(";").explode()
           .str.split(" (", regex=False).str[0].str.strip())
top = ky_nang.reset_index().drop_duplicates()["yeu_cau_ky_nang"].value_counts()
print(f"{len(df)} tin, theo nguồn:", df["nguon"].value_counts().to_dict())
print(top.head(8).to_string())

Bảng này đếm riêng từng kỹ năng, còn biểu đồ ở đầu bài gộp các kỹ năng cùng nhóm, nên LLM, RAG và AI agent gộp lại thành 27 tin.
Lần chạy đầu thì không suôn sẻ như vậy. Mình muốn bỏ phần trong ngoặc của những dòng như "AWS (Bedrock)", nên tách chuỗi theo " (". Pandas báo lỗi ngay:
re.PatternError: missing ), unterminated subpattern at position 1

Hóa ra khi chuỗi tách dài hơn một ký tự, pandas mặc định coi nó là regex, và dấu ( mở một nhóm regex không có ngoặc đóng. Tài liệu str.split ghi rõ điều này, thêm regex=False là xong. Chặng 2 có rất nhiều lúc như thế. Dữ liệu thật hay có ký tự lạ, và phần lớn thời gian của bạn là đọc lỗi rồi gỡ.
Chặng 3: Machine Learning với scikit-learn
Bạn học hồi quy, phân loại, phân cụm, cách chia dữ liệu train và test, chọn metric, và tránh data leakage (thông tin của tập test lọt vào lúc train). Chặng này xong khi bạn train được một model và giải thích được con số đánh giá của nó.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
model = LogisticRegression(max_iter=5000).fit(X_train, y_train)
print("Độ chính xác trên tập test:", round(model.score(X_test, y_test), 3))

Model đoán đúng 95,6% số ca trong phần dữ liệu nó chưa thấy. Nghe thì cao, nhưng đây là dữ liệu chẩn đoán ung thư vú. Bỏ sót một ca ác tính nguy hiểm hơn nhiều so với báo nhầm một ca lành, nên chỉ nhìn độ chính xác chung thì chưa đủ để nói model tốt. Phần lớn chặng 3 xoay quanh những câu hỏi kiểu này: đo bằng gì, và con số đó có ý nghĩa gì với bài toán.
Bộ dữ liệu trên toàn là số và đã sạch sẵn. Dữ liệu khách hàng thật, như ở project dự đoán khách rời bỏ, thì có cột chữ, ví dụ tên thành phố. Phần lớn model của scikit-learn chỉ nhận số, nên đưa thẳng cột đó vào là gặp ValueError: could not convert string to float: 'Hà Nội'. Cách làm quen thuộc là gói bước mã hóa cột chữ và model vào chung một Pipeline:
tien_xu_ly = make_column_transformer(
    (OneHotEncoder(handle_unknown="ignore"), ["thanh_pho"]), remainder="passthrough")
model = make_pipeline(tien_xu_ly, LogisticRegression())
model.fit(df[["thanh_pho", "so_don"]], df["roi_bo"])

Gói chung như vậy còn có thêm một lợi ích: khi chia train và test, bước mã hóa chỉ học trên tập train, nên không vô tình gây data leakage. Đây là một phần của feature engineering trong bảng ở trên.
Chặng 4: Deep Learning và GenAI với PyTorch
Bạn học mạng nơ-ron, PyTorch, computer vision, xử lý ngôn ngữ, kiến trúc Transformer, rồi dùng LLM qua API và Hugging Face. Từ đây bạn bắt đầu cần GPU và quen dần với việc làm trên GPU server qua SSH. Chặng này xong khi bạn tự viết được vòng lặp train và hiểu từng dòng làm gì.
Vẫn bộ dữ liệu ung thư vú, lần này giải bằng một mạng nơ-ron nhỏ:
import torch
from torch import nn

model = nn.Sequential(nn.Linear(30, 16), nn.ReLU(), nn.Linear(16, 1))
opt = torch.optim.Adam(model.parameters(), lr=0.01)
loss_fn = nn.BCEWithLogitsLoss()
for epoch in range(1, 101):
    opt.zero_grad()
    loss = loss_fn(model(X_train).squeeze(1), y_train)
    loss.backward()
    opt.step()

Mình lược bước chuẩn hóa dữ liệu và chuyển sang tensor cho gọn. Sau 100 epoch, loss giảm từ 0,7468 xuống 0,0372, độ chính xác trên tập test lên 0,982. Ở chặng 3 bạn gọi fit là xong, còn ở đây bạn tự viết từng bước: tính loss, lan truyền ngược, cập nhật trọng số. Hiểu vòng lặp này rồi thì đọc code train model lớn hơn sẽ không còn lạ.
Chặng 5: Ứng dụng LLM và AI Agent
Đây là phần việc mà phần lớn tin tuyển dụng AI Engineer mô tả: 27 trên 35 tin nhắc LLM, RAG hoặc agent. Chặng này gồm:
Gọi LLM qua API, viết prompt cho ứng dụng.
RAG: cho model trả lời dựa trên tài liệu riêng, dùng embedding và vector database.
Agent: model tự gọi công cụ, nối với hệ thống khác qua MCP.
Evals: chấm chất lượng câu trả lời bằng một bộ câu hỏi có đáp án.
Deploy: đóng gói bằng FastAPI và Docker, tự host model bằng vLLM.
Evals nghe thì khô, nhưng không có nó thì không ai nói được ứng dụng tốt đến đâu. Bộ evals đơn giản nhất chỉ là một file vài chục câu hỏi kèm đáp án đúng do bạn tự soạn. Mỗi lần sửa prompt hay đổi model, bạn chạy lại cả bộ để xem số câu đúng tăng hay giảm. Nhờ vậy bạn biết chắc thay đổi vừa rồi làm ứng dụng tốt lên hay tệ đi, thay vì chỉ thấy nó "có vẻ tốt hơn".
Chặng này xong khi ứng dụng của bạn có link công khai, có bộ evals cho biết nó trả lời đúng bao nhiêu phần trăm, và không sập khi người dùng gõ linh tinh. Trên blog có hai bài thực hành gần với chặng này: Ollama là gì (tự host LLM, gọi API giống OpenAI) và n8n MCP (cho Claude Code dựng workflow qua MCP).
Trong 35 tin mình đọc, 19 tin đòi từ 3 năm kinh nghiệm. Người mới chưa có số năm đó thì thứ đưa ra được là sản phẩm, một ứng dụng chạy thật mà người tuyển dụng bấm vào xem được.
Nên bắt đầu lộ trình AI Engineer từ chặng nào?
Không phải ai cũng bắt đầu từ số 0. Đã viết Python quen tay thì bỏ qua chặng 1. Ngày nào cũng dùng pandas thì vào thẳng chặng 3. Nếu chưa chắc, trang thứ hai của bản đồ có 15 câu tự chấm. Bạn đánh dấu những việc hôm nay tự làm được mà không tra cứu, rồi đọc bảng kết quả từ trên xuống, dừng ở dòng đầu tiên đúng với mình.

Mất bao lâu để đi hết?
Theo đề cương của AIDev, cả lộ trình có khoảng 118 giờ video. Cộng thời gian làm bài tập và project, bọn mình ước khoảng 360 đến 400 giờ. Các chặng không dài bằng nhau: chặng 2 dài nhất (khoảng 29 giờ video) vì gom nhiều mảng nhất, chặng 5 đứng thứ hai. Chia tổng số giờ theo nhịp học thì ra:
Mỗi tuần học | Đi hết 5 chặng | Thường hợp với |
|---|---|---|
5 đến 6 giờ | khoảng 14 đến 18 tháng | Người đi làm, chỉ học được vài tối trong tuần |
10 đến 12 giờ | khoảng 7 đến 9 tháng | Người đi làm, học đều buổi tối và cuối tuần |
15 đến 20 giờ | khoảng 4 đến 6 tháng | Sinh viên, người đang có nhiều thời gian rảnh |
Đó là khi đã có đề cương sẵn. Tự học bằng tài liệu miễn phí thường lâu hơn, vì phải tự nối các khóa rời nhau và tự gỡ khi kẹt. Bài tự học AI liệt kê tài liệu miễn phí cho từng chặng nếu bạn muốn đi theo cách đó.
Có cần máy mạnh không?
Ba chặng đầu thì không cần card rời. Toàn bộ code trong bài, kể cả mạng nơ-ron ở chặng 4, mình chạy bằng CPU trên máy Mac M4 Pro. Lâu nhất là lần train 100 epoch, hết 3,6 giây tính cả lúc nạp thư viện. Máy yếu hơn sẽ chậm hơn, mình chưa đo trên laptop khác.
Đến chặng 4, khi train model ảnh hay model ngôn ngữ thật, bạn mới cần GPU. Rẻ nhất là Google Colab hoặc Kaggle Notebook, có GPU miễn phí nhưng giới hạn giờ dùng. Kế đến là thuê GPU server theo giờ, dùng lúc nào trả lúc đó. Mua card chỉ đáng khi ngày nào bạn cũng chạy GPU nhiều giờ. Bài AI Local có số đo để quyết định mua hay thuê.
Đi hết lộ trình thì portfolio có gì?
Năm project và dự án cuối khóa là phần bạn đưa vào CV. Mỗi cái nên có repo GitHub, README ghi rõ con số đo được, và một video demo ngắn. Người tuyển dụng đọc một dòng "ứng dụng trả lời đúng bao nhiêu trên 50 câu evals" sẽ hiểu bạn làm được gì nhanh hơn nhiều so với một dòng liệt kê mười công nghệ.
Khi nào lộ trình này không hợp với bạn?
Bạn chỉ muốn dùng ChatGPT, Claude cho việc văn phòng. Học cách dùng công cụ là đủ, không cần đi 5 chặng.
Bạn muốn làm nghiên cứu, tạo ra model mới. Hướng đó cần toán sâu hơn nhiều và thường đi qua thạc sĩ, tiến sĩ.
Bạn không giữ được nhịp học đều trong nhiều tháng. Bỏ dở lâu thì đến chặng sau đã quên chặng trước.
Câu hỏi thường gặp
Học lộ trình AI Engineer có cần bằng CNTT không?
Để học thì không. Lúc xin việc thì có thể: 22 trên 35 tin mình đọc có ghi yêu cầu bằng cấp, nhưng 11 tin trong số đó chỉ ghi "Đại học trở lên" hoặc "Cao đẳng trở lên", không nêu ngành. Phần kỹ năng trong các tin thì được viết dài và cụ thể hơn hẳn phần bằng cấp.
Người trái ngành học được không?
Được, nếu chịu bắt đầu từ chặng 1 và đi chậm hơn ở chặng này. Lợi thế của người trái ngành là hiểu một lĩnh vực cụ thể, nên hãy chọn bài tập gần nghề cũ: làm kế toán thì phân tích hóa đơn, làm bán hàng thì phân tích đơn hàng.
Nên học Data Science hay AI Engineer?
Ba chặng đầu là phần chung của cả hai. Học xong chặng 2 hoặc 3 rồi hẵng chọn: thích phân tích, trả lời câu hỏi kinh doanh thì dừng ở nghề dữ liệu, thích xây sản phẩm thì đi tiếp chặng 4 và 5.
Học bằng tiếng Việt có đủ không?
Phần nền thì đủ, vì Python, pandas có khá nhiều tài liệu tiếng Việt. Càng về chặng 4 và 5, bài báo gốc, tài liệu thư viện và thảo luận trên mạng gần như chỉ có tiếng Anh. Thông báo lỗi thì bằng tiếng Anh ngay từ chặng 1. Học khái niệm bằng tiếng Việt cho nhanh hiểu, còn đọc tiếng Anh kỹ thuật thì nên luyện dần từ chặng đầu.
AI viết code được rồi, có còn cần học Python không?
Có. Claude hay ChatGPT viết code rất nhanh, nhưng code đó vẫn cần người đọc hiểu, chạy thử và biết khi nào nó sai. Lý do giống hệt chuyện chatbot RAG ở đầu bài: không hiểu phần bên dưới thì không biết lỗi nằm ở đâu. Trong lúc học, bạn vẫn có thể nhờ AI giải thích đoạn code khó, miễn là tự gõ lại và tự sửa được.
Cần giỏi toán đến mức nào?
Chặng 1 và 2 chỉ cần toán phổ thông. Chặng 3 cần xác suất, thống kê và làm quen với ma trận. Chặng 4 cần đạo hàm ở mức dùng được, không cần chứng minh. Học toán đến đâu dùng đến đó dễ vào hơn là học dồn một lượt từ đầu.
Đọc tiếp
AI Engineer là gì, cần học gì: phân tích 35 tin tuyển dụng, kinh nghiệm và lương.
Tự học AI có được không: tài liệu miễn phí cho từng chặng.
AI Local: chạy LLM và AI tạo ảnh trên máy bạn: khi nào cần GPU.
Nếu muốn đi lộ trình này với đề cương sẵn, bằng tiếng Việt, dữ liệu Việt Nam và project được chấm, xem lộ trình AI Engineer từ số 0 của AIDev: 5 khóa, 32 chương, 5 project và một dự án cuối khóa tự chọn đề tài.
Code trong bài chạy ngày 11/10/2026 trên máy Mac M4 Pro (CPU), Python 3.14.7, pandas 3.0.6, scikit-learn 1.9.1, PyTorch 2.14.1. Dữ liệu tuyển dụng: 35 tin AI Engineer trên ITviec, TopCV, LinkedIn cùng ngày. Số giờ và số chương lấy theo đề cương lộ trình AI Engineer từ số 0 của AIDev, 10/2026.
Chuyên mục
Học AI
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.