Machine Learning thực chiếnMachine Learning thực chiến
Khóa 3/5 · Lộ trình AI Engineer từ số 0
Trung cấpMachine Learning thực chiến
Từ một bảng dữ liệu đã sạch đến một model dự đoán chạy được và giải thích được cho người không kỹ thuật.
- 56 bài · ~20,1 giờ video
- Project 3: dự đoán churn end-to-end, nộp GitHub
- Chọn thuật toán, pipeline sklearn chống leakage, đúng metric
Ai nên học khóa này, và học xong làm được gì
Cần thạo pandas và hiểu thống kê suy diễn cơ bản. Phần machine learning khóa sẽ dạy.
Dành cho ai
Vừa học xong Khóa 2
Đã biết mô tả dữ liệu, giờ muốn dự đoán.
Data Analyst muốn đi xa hơn
Ai sắp rời bỏ, giá nào hợp lý, rủi ro ở đâu.
Đã tự học sklearn qua tutorial
Chạy được, nhưng chưa chắc kết quả đáng tin.
Yêu cầu đầu vào
Hoàn thành Khóa 1 và Khóa 2, hoặc thạo pandas và thống kê suy diễn.
Bài kiểm tra đầu vào 15 câu chỉ ra phần bạn còn hổng để ôn.
Không cần toán đại học: toán dừng ở mức trực giác.
Máy Windows hoặc macOS thông thường, không cần GPU.
Bạn sẽ làm được gì
Chọn thuật toán hợp lý cho bài toán dự đoán trên dữ liệu bảng.
Gói tiền xử lý và model vào pipeline sklearn, không bị leakage.
Đánh giá bằng đúng metric và tinh chỉnh có experiment log.
Giải thích model bằng SHAP cho người không làm kỹ thuật.
Kỹ năng bạn sẽ có sau khóa
Kỹ năng nào cũng có bài tập trong 5 chương của khóa.
- scikit-learn
- Pipeline sklearn
- Cross-validation
- Chống data leakage
- Linear & Logistic
- Ridge & Lasso
- Random Forest
- LightGBM
- K-Means & PCA
- Dữ liệu mất cân bằng
- GridSearchCV
- Feature engineering
- SHAP
- Experiment log
5 chương + Project 3, 56 bài, từ khung tư duy đến model giải thích được
Chương 1 dựng khung tư duy, 2–3 là hồi quy và phân loại, 4 là học không giám sát, 5 là feature engineering và tinh chỉnh, chương 6 là Project 3.
- Nhập môn ML12 bài · 3h50'
- Hồi quy8 bài · 2h40'
- Phân loại14 bài · 4h40'
- Không giám sát6 bài · 2h05'
- Feature & tinh chỉnh10 bài · 3h35'
1Nhập môn ML & đánh giá model
12 bài · 3h50'
- Bài 1.2: Môi trường Khóa 3 & dữ liệu Tiệm Mây hai năm sau18 phút
- Bài 1.3: ML là gì & bản đồ bài toán20 phút · thực hành: tỉ lệ rời bỏ theo hạng thành viên, xếp loại bài toán (có cần ML không), chọn cột được làm feature
- Bài 1.4: Quy trình sáu bước & API fit, predict, score20 phút
- Bài 1.5: Baseline & demo giá nhà từ đầu đến cuối20 phút · thực hành: fit một lần predict nhiều lần, baseline lười của bài churn, feature đơn lẻ nào đoán giá tốt nhất so với baseline
- Bài 1.6: Train, validation, test: không chấm bài trên đề đã ôn18 phút
- Bài 1.7: Data leakage: lỗi âm thầm nguy hiểm nhất20 phút
- Bài 1.8: Pipeline đầu tiên: sửa leakage bằng make_pipeline18 phút · thực hành: chia ba phần 70/15/15 có stratify, soi cột liên quan mạnh khó tin bằng hệ số tương quan, pipeline scale và logistic chống leakage
- Bài 1.9: Cross-validation: tin kết quả đến đâu18 phút
- Bài 1.10: Metric cho hồi quy: MAE, RMSE, R²18 phút
- Bài 1.11: Metric cho phân loại: confusion matrix, precision, recall, F1, ROC-AUC20 phút · thực hành: tự viết MAE, RMSE, MAPE, tự đếm precision, recall, F1, so logistic với model lười bằng cross-validation
- Bài 1.12: Overfitting, underfitting & bias–variance20 phút
- Bài 1.13: Learning curve & cách chữa20 phút · thực hành: chọn bậc đa thức trên điểm chưa thấy, đọc learning curve thành lời khuyên, tìm cỡ dữ liệu đủ dùng
2Hồi quy
8 bài · 2h40'
- Bài 2.1: Đường thẳng khớp nhất & gradient descent bằng hình20 phút
- Bài 2.2: LinearRegression & diễn giải hệ số20 phút · thực hành: hàm MSE, số bước gradient descent tới đáy, dự đoán lương, câu diễn giải hệ số theo khuôn
- Bài 2.3: Hồi quy đa biến & multicollinearity20 phút
- Bài 2.4: Feature dạng nhóm: one-hot trong pipeline18 phút
- Bài 2.5: PolynomialFeatures & overfitting quay lại20 phút · thực hành: hệ số đã scale xếp hạng feature, cặp feature tương quan mạnh, pipeline one-hot định giá tin mới, RMSE CV theo bậc đa thức
- Bài 2.6: Ridge, Lasso & chọn alpha bằng CV22 phút
- Bài 2.7: Khi giá lệch phải: hồi quy trên log20 phút
- Bài 2.8: Mini-project giá nhà: so model & viết kết luận20 phút · thực hành: ridgeCV chọn alpha có và không có log, Lasso giữ feature nào, model log giá đạt ngưỡng MAE, sai số phần trăm theo loại nhà
3Phân loại: từ logistic đến boosting
14 bài · 4h40'
- Bài 3.1: Sigmoid: từ điểm số đến xác suất18 phút
- Bài 3.2: LogisticRegression trên bài churn20 phút
- Bài 3.3: Hệ số & odds: logistic nói được lý do18 phút · thực hành: hàm log_odds, pipeline logistic đạt ngưỡng ROC-AUC kèm 5 khách rủi ro nhất, feature có odds ratio lớn hơn 1, hạ ngưỡng thì được gì, mất gì
- Bài 3.4: KNN, chọn K & ranh giới quyết định20 phút
- Bài 3.5: Scale dữ liệu: vì sao KNN bắt buộc18 phút · thực hành: chọn K trên tập validation, đo chênh lệch có và không scale, pipeline RobustScaler và KNN đạt ngưỡng
- Bài 3.6: Cây quyết định: vẽ, đọc và tỉa22 phút
- Bài 3.7: Random Forest: trí tuệ đám đông20 phút · thực hành: tỉ lệ rời bỏ theo lá, chọn min_samples_leaf bằng CV, Random Forest đạt ngưỡng kèm feature quan trọng nhất
- Bài 3.8: Boosting: học từ sai lầm của người đi trước18 phút
- Bài 3.9: LightGBM & early stopping22 phút
- Bài 3.10: Chọn model cho dữ liệu bảng20 phút · thực hành: vòng lặp boosting tự viết, LightGBM đạt ngưỡng, early stopping, bảng xếp hạng model cùng CV
- Bài 3.11: Model lười & ngưỡng theo tiền22 phút
- Bài 3.12: ROC & PR: đọc đúng khi dữ liệu lệch20 phút · thực hành: so model lười với logistic, hàm lợi nhuận chiến dịch, ngưỡng có lợi nhuận cao nhất, PR-AUC so với ROC-AUC trên hai bộ
- Bài 3.13: class_weight & khi nào nghĩ tới SMOTE20 phút
- Bài 3.14: Hiệu chỉnh xác suất & TunedThresholdClassifierCV22 phút · thực hành: tác dụng phụ của class_weight, hiệu chỉnh xác suất, chọn ngưỡng theo lợi nhuận bằng TunedThresholdClassifierCV
4Học không giám sát
6 bài · 2h05'
- Bài 4.1: K-Means qua từng vòng lặp20 phút
- Bài 4.2: Scale trước khi phân cụm & chọn K22 phút · thực hành: k-Means trên dữ liệu thô so với lấy log rồi scale, bốn cụm theo hành vi, bảng silhouette chọn K
- Bài 4.3: Hierarchical clustering & dendrogram20 phút
- Bài 4.4: PCA: nén nhiều feature về 2 chiều21 phút · thực hành: ward so với K-Means bằng ARI, cắt cây thành ba cụm, PCA giữ bao nhiêu phương sai, cột nặng nhất, quên scale thì sao
- Bài 4.5: Case RFM: dựng bảng & phân cụm21 phút
- Bài 4.6: Case RFM: đặt tên phân khúc & hành động21 phút · thực hành: bảng RFM ở mốc 31/12/2025, bốn phân khúc, hồ sơ phân khúc
5Feature, pipeline, tinh chỉnh & giải thích model
10 bài · 3h35'
- Bài 5.1: Feature tốt hơn thuật toán xịn & cột nhóm22 phút
- Bài 5.2: Feature từ ngày, binning & tương tác22 phút
- Bài 5.3: Dữ liệu thiếu trong pipeline20 phút · thực hành: hạng thành viên theo thứ tự, gom tỉnh hiếm, feature từ hai cột ngày, tỉ lệ đổi trả, pipeline có bước điền ô trống
- Bài 5.4: ColumnTransformer & Pipeline trọn gói22 phút
- Bài 5.5: Feature tự viết, lưu & nạp pipeline22 phút · thực hành: pipeline hai nhánh với ColumnTransformer, đếm cột sau tiền xử lý, thêm feature bằng FunctionTransformer, lưu, nạp và chấm quý sau
- Bài 5.6: Hyperparameter & GridSearchCV22 phút
- Bài 5.7: RandomizedSearchCV & Halving21 phút
- Bài 5.8: Nested cross-validation: điểm thật sau khi tinh chỉnh20 phút · thực hành: tinh chỉnh C của pipeline logistic, lưới LightGBM, RandomizedSearchCV đạt ngưỡng, nested CV cho điểm trung thực
- Bài 5.9: Permutation importance21 phút
- Bài 5.10: SHAP: giải thích từng dự đoán23 phút · thực hành: ba cột quan trọng nhất bằng permutation importance, khách rủi ro nhất và ba lý do bằng SHAP, kiểm phép cộng của SHAP
Tổng: 56 bài (gồm 6 bài Project 3) · ~20,1 giờ
Một bài toán churn end-to-end, kết bằng báo cáo kinh doanh
Sáu bài hướng dẫn từ đề bài đến lúc nộp. Bạn tự làm trước, rồi xem video để so lại bài mình.
Project 3: Dự đoán khách hàng rời bỏ end-to-end
Bài toán churn trọn vẹn trên dữ liệu Tiệm Mây: từ baseline logistic đến model có feature engineering và tinh chỉnh, chọn ngưỡng theo chi phí giữ chân, kết bằng báo cáo đề xuất hành động. Chấm theo rubric 25 điểm cho năm phần, đạt từ 18.
Đề bài & baseline
Dựng baseline logistic trong pipeline, mở experiment log từ đầu.
Cải tiến có hệ thống
Feature engineering, xử lý mất cân bằng, đua model, biết lúc nào dừng.
Báo cáo kinh doanh & nộp bài
Chọn ngưỡng theo chi phí, viết báo cáo một trang, nộp kèm pipeline.
Sản phẩm cho thấy bạn làm trọn vòng đời một model, và là điều kiện nhận chứng nhận Khóa 3. Ở Khóa 4, chính pipeline này được đưa lên web.
Học xong khóa này, bạn có gì trong tay
Những gì bạn mang sang khóa học tiếp theo.
Bạn có trong tay
Pipeline sklearn cho bài churn, lưu bằng joblib.
Experiment log từ baseline đến model đã tuning.
Báo cáo một trang kèm danh sách khách nên giữ chân.
Thói quen gói tiền xử lý vào pipeline chống leakage.
Khóa tiếp theo
Deep Learning & GenAI
Chương 18–23 · 62 bài · ~20,8 giờ video
Lối ra nghề gần nhất: Nghề dữ liệu, sau Khóa 2 hoặc 3
- Data Analyst
- BI Analyst
- Data Scientist
- Product Analyst
Vị trí lấy theo mô tả tuyển dụng công khai, không phải cam kết việc làm. Kết quả phụ thuộc vào năng lực, nỗ lực và bối cảnh của từng học viên.
Khóa này dạy như thế nào
Thuật toán nào cũng đi một trình tự: hình vẽ cho trực giác, code, rồi khi nào nên dùng. Toán dừng ở trực giác, không chứng minh. Một bài churn đi qua năm họ model.
Giảng viên của khóa học
Cả lộ trình, gồm khóa này, do một người soạn, quay và đứng lớp.
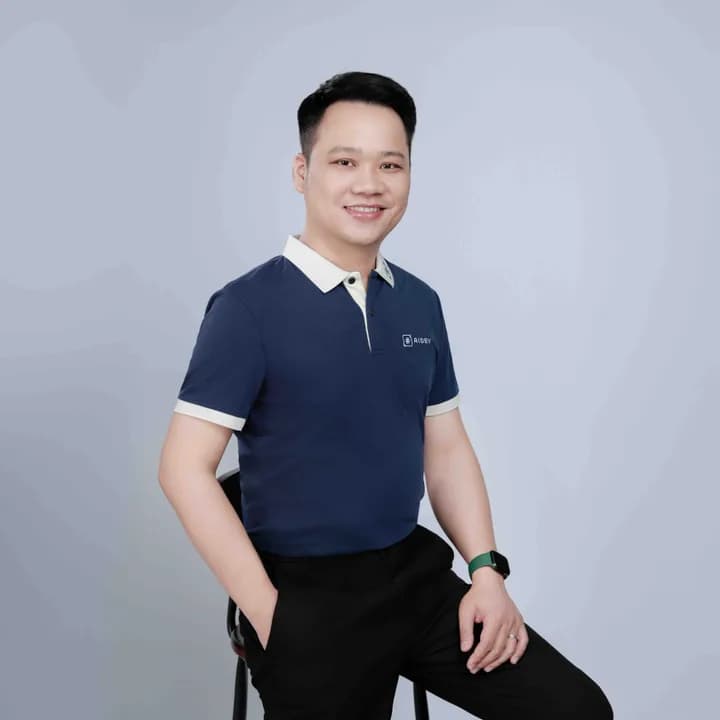
Nguyễn Việt Chung
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
Xây hệ thống AI cho doanh nghiệp tại VietPlatform.
Mua riêng khóa này, hoặc đi trọn lộ trình
Học phí trả một lần. Nếu sau này bạn muốn học tiếp, khoản đã đóng cho khóa này được trừ toàn bộ vào gói cao hơn.
Khuyên chọn · Trọn lộ trình
Combo trọn lộ trình
5 khóa + Capstone + chứng nhận
Giá flash sale: 2.490.000 ₫
Giá ưu đãi khai giảng · đến hết 19/11/2026
Tiết kiệm 2.096.000 ₫ (46%) so với mua lẻ 5 khóa
Khóa này nằm trong gói
Chỉ khóa này
Machine Learning thực chiến
Giá bán: 899.000 ₫
Sở hữu trọn đời
Dự kiến phát hành tháng 12/2026 · Vào học ngay khi khóa phát hành
Học phí đã đóng được trừ toàn bộ khi nâng lên trọn lộ trình
Khóa học là nội dung số; sau khi mở quyền truy cập, học phí không được hoàn lại. Xem điều khoản khóa học
Cam kết của AIDev
Khóa vẫn đang quay dần, nên mua sớm cũng có rủi ro. Phần rủi ro đó AIDev nhận về mình.
Sở hữu trọn đời
Trả một lần, không phí duy trì, xem lại bao nhiêu lần cũng được.
Cập nhật nội dung miễn phí
Bài nào phải quay lại hoặc bổ sung, bạn nhận bản mới mà không đóng thêm.
Nâng gói được trừ học phí
Khi nâng lên gói cao hơn, toàn bộ học phí bạn đã đóng được trừ vào giá gói mới.
Những câu hỏi riêng của khóa này
Câu hỏi về gói trọn lộ trình và chứng nhận có ở trang lộ trình.
Cần toán đến mức nào để học được khóa này?
Bốn phép tính, phần trăm và khả năng đọc một biểu đồ là đủ. Mỗi thuật toán được dạy bằng hình trước: gradient descent là người xuống đồi trong sương mù, bias và variance là bia bắn, regularization là dây cương ghìm hệ số. Khóa không có đạo hàm và không có chứng minh. Ai muốn xuống sâu hơn có Phụ lục A "Toán vừa đủ cho ML" của sách Machine Learning thực chiến để đọc riêng, không tính vào giờ chính khóa.
Làm sao biết bài toán của tôi nên dùng thuật toán nào?
Chương 3 trả lời đúng câu này. Năm họ model (logistic, KNN, cây quyết định, Random Forest, boosting với LightGBM) chạy trên cùng một bài churn, mỗi bài đóng lại bằng phần khi nào dùng và khi nào không. Bài 3.10 "Chọn model cho dữ liệu bảng" tổng kết thành một nguyên tắc dùng được ngay: bắt đầu bằng logistic làm baseline, kết thúc bằng boosting, kèm tờ Bản đồ chọn model cho dữ liệu bảng để in ra dùng. XGBoost chỉ xuất hiện trong bảng so sánh, không phải cài.
Data leakage là gì mà khóa nhắc suốt?
Là khi thông tin của tập test, hoặc của chính label, lọt vào lúc train, thường qua một bước tiền xử lý chạy trước khi split. Model trông rất giỏi trên máy bạn và sai bét khi chạy thật. Bài 1.7 dựng hẳn một thí nghiệm rò label cho bạn thấy điểm sụp thế nào khi sửa lỗi đó, bài 1.8 sửa ngay bằng Pipeline để lỗi này không xảy ra được nữa, kèm Checklist chống data leakage. Leakage khi tạo feature từ thông tin tương lai nằm ở bài 5.2 và trong Project 3.
Model của tôi accuracy 95%, sao vẫn bị chê?
Vì bài toán thật hiếm khi cân bằng. Bộ hồ sơ vay của khóa chỉ khoảng 5% vỡ nợ, nên một model "lười" đoán tất cả là "không vỡ nợ" đã có accuracy 95% mà không giúp được gì. Churn của khóa khoảng 18%, lệch ít hơn nhưng vẫn đủ để accuracy đánh lừa. Bài 1.11 dạy confusion matrix, precision, recall, F1 và ROC-AUC. Bài 3.11–3.14 xử lý phần còn lại: model lười và ngưỡng theo tiền, đọc ROC và PR khi dữ liệu lệch, class_weight, hiệu chỉnh xác suất và TunedThresholdClassifierCV. SMOTE chỉ được giới thiệu tên kèm cảnh báo, khóa không dùng.
Sếp hỏi vì sao model nói khách này sắp rời bỏ thì trả lời thế nào?
Bài 5.9–5.10 dành riêng cho việc đó. Bạn học permutation importance để biết yếu tố nào thật sự quan trọng, rồi SHAP ở mức thực dụng: giải thích từng dự đoán một, kiểu "khách này rủi ro cao vì sáu tháng không mua và có khiếu nại". Notebook cuối chương 5 là bài giải thích model churn cho giám đốc, và bài 3.6 còn dạy vẽ và đọc một cây quyết định cho sếp.
Project 3 làm ra cái gì?
Một bài toán churn hoàn chỉnh trên dữ liệu Tiệm Mây: baseline, hai vòng cải tiến có nhật ký thí nghiệm, model cuối đã tinh chỉnh, ngưỡng chọn theo chi phí giữ chân khách, cộng báo cáo một trang cho người không kỹ thuật kèm danh sách khách nên gửi mã giữ chân. Rubric 25 điểm chia năm phần: baseline và nhật ký 4, feature 5, model và tinh chỉnh 5, ngưỡng và tiền 4, giải thích, báo cáo và đóng gói 7; đạt từ 18. Pipeline đóng gói bằng joblib, và chính nó là thứ Khóa 4 đưa lên web thành ứng dụng chạy thật.
Khóa có dạy deep learning hay đưa model lên production không?
Không. Khóa 3 dừng ở dữ liệu bảng, nơi boosting vẫn thắng neural network trong phần lớn bài toán doanh nghiệp, và kết thúc ở một pipeline lưu bằng joblib. Mạng nơ-ron, PyTorch, LLM và phần đưa model lên web là nội dung Khóa 4. Đổi lại, những gì bạn học ở đây dùng được ngay trong công việc mà không cần GPU hay hạ tầng gì thêm. Thực hành trên lab.aidev.edu.vn/k3, notebook có bộ chấm tự động.
Khóa này nằm ở đâu trong lộ trình?
Khóa 3/5 của Lộ trình AI Engineer từ số 0, gồm chương 13–17. Khóa ngay trước là Phân tích dữ liệu với Python (chương 6–12), khóa ngay sau là Deep Learning & GenAI (chương 18–23). Khi nâng lên gói cao hơn, toàn bộ học phí bạn đã đóng được trừ vào giá gói mới.
Có được hoàn tiền không?
Không. Khóa học là nội dung số; sau khi mở quyền truy cập, học phí không được hoàn lại. Trước khi trả tiền bạn có chương 1 miễn phí, đề cương đến từng bài và một video xem thử mỗi khóa để quyết định.
Sở hữu trọn đời nghĩa là gì?
Là bạn truy cập được nội dung đã mua trong suốt vòng đời nền tảng học của AIDev, tối thiểu 5 năm kể từ ngày mua, gồm mọi bản cập nhật nội dung miễn phí. Không gồm các dịch vụ hỗ trợ kèm theo gói như buổi live, chấm tay hay mentor, vốn có thời hạn riêng của gói đó.
Cần tư vấn trước khi đăng ký?
Để lại thông tin, AIDev gọi lại xem khóa có hợp với bạn không, và báo bạn khi bộ dữ liệu churn cùng starter kit của Project 3 sẵn sàng để tải.
Còn câu hỏi? Nhắn ZaloTelegramhoặc gọi085 939 6969