AI automation cho marketing: việc nào nên tự động trước

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 11 phút đọc1 lượt xem
Mục lục · 16
Việc marketing nên tự động trước là việc lặp lại mỗi tuần, có khuôn rõ và có người duyệt trước khi đăng, như viết nháp caption, tiêu đề email từ bài mới. Mình dựng workflow n8n đọc RSS blog, cho AI viết 120 bản nháp, tự kiểm số liệu và từ cấm, rồi đọc tay xem bộ kiểm bỏ sót gì.
Với marketing automation AI, việc nên tự động trước là việc lặp lại mỗi tuần, đầu vào có sẵn và có người duyệt trước khi lên kênh: viết nháp caption, tiêu đề email từ bài mới, gắn link có mã UTM (tham số thêm vào link để biết khách đến từ kênh nào), gom số liệu tuần. Việc nên để sau là việc nói thay thương hiệu mà không ai xem lại, như tự đăng bài, trả lời khiếu nại hay báo giá.
Những điều cần nắm trước khi đọc tiếp:
Mình dựng một workflow (chuỗi bước chạy tự động) trên n8n, công cụ nối các khối thành quy trình, đọc RSS (bản tin tự động liệt kê bài mới) của blog AIDev, cho AI viết một caption Facebook và một tiêu đề email cho mỗi bài, rồi đưa vào bảng chờ duyệt. Workflow chạy 6 lần trên 20 bài, ra 120 bản nháp.
Bộ kiểm tự động không thấy con số nào AI tự bịa, nhưng gắn cờ 13 bản: 10 tiêu đề email dài quá 60 ký tự, 4 lần dính từ cấm (một bản dính cả hai). 3 trong 4 lần từ cấm là bắt nhầm.
Đọc tay 40 bản, mình thấy một caption sai ý mà bộ kiểm không bắt được, vì mọi con số trong đó đều có trong bài gốc.
Model gemma4:e2b chạy trên GPU Tesla P40 viết xong 20 bài trong khoảng 15 giây, gemma4:e4b mất khoảng 23 giây.
Nếu bạn chưa rõ AI automation khác tự động hóa thường ở đâu, đọc bài AI automation là gì trước.
Marketing automation AI khác gì marketing automation thường?
Marketing automation (tự động hóa marketing) thường là các luật cố định: khách điền form thì gửi email chào mừng, bỏ giỏ hàng 2 giờ thì gửi nhắc, mở email thì gắn nhãn. Khi thêm AI, quy trình làm thêm được những việc trước đây phải có người viết hay người đọc: soạn nháp nội dung từ một bài gốc, xếp loại bình luận, tóm tắt phản hồi của khách.
Cái khó là AI có thể viết sai mà trông vẫn trơn tru. Vì vậy, khi chọn việc để tự động, mình hỏi hai câu: sai một lần thì mất gì, và ai kịp sửa trước khi khách thấy.
Việc marketing nào nên tự động trước?
Mình xếp theo hai câu hỏi: việc có lặp lại đủ nhiều không, và có người duyệt trước khi lên kênh không.
Việc | Để AI làm gì | Người làm gì | Nên tự động |
|---|---|---|---|
Đăng bài blog mới lên Facebook, email | viết nháp caption, tiêu đề email | duyệt, sửa, bấm đăng | trước tiên |
Gắn link UTM, rút gọn link | không cần AI, luật làm đủ | không | trước tiên |
Báo cáo số liệu tuần (lượt xem, đơn hàng) | viết vài dòng nhận xét từ bảng số | đọc, kiểm số | sớm |
Xếp loại bình luận, tin nhắn | xếp loại hỏi giá, khen, phàn nàn | xử lý các tin phàn nàn | sớm, có người theo dõi |
Chấm điểm khách tiềm năng từ form | đọc ô ghi chú tự do | gọi lại khách điểm cao | khi đã có đủ form |
Trả lời khiếu nại, báo giá, hứa giao hàng | không giao cho AI tự gửi | người viết | không |
Tự đăng bài không qua ai | không | không |
Hàng đầu tiên là việc mình thử trong bài: rủi ro thấp vì có người duyệt, và tuần nào cũng lặp lại. Bài n8n workflow mẫu có sẵn template xếp loại phản hồi khách nếu bạn muốn thử việc ở hàng thứ tư: xếp loại bình luận, tin nhắn.
Workflow viết nháp từ bài blog mới trông thế nào?

Mình gọi workflow bằng một lệnh curl ngay trên máy chạy n8n, mỗi lệnh là một lượt 20 bài:
curl -s -X POST http://127.0.0.1:5678/webhook/mkt-gemma4-e2b
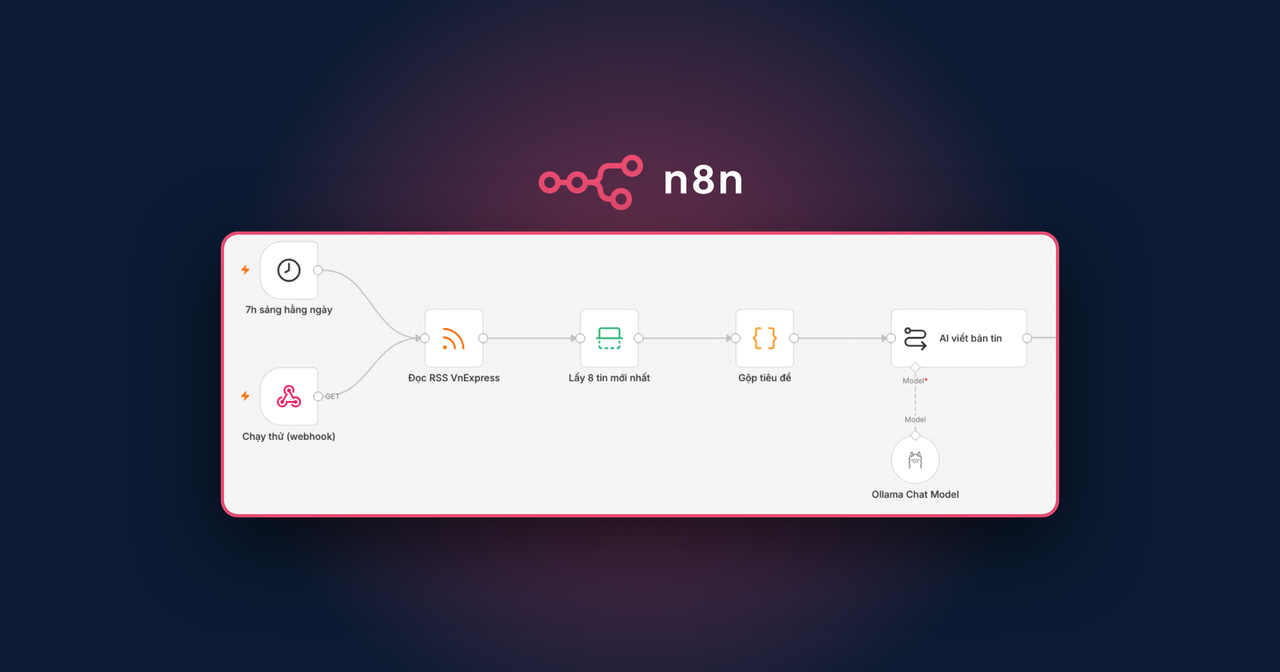
Workflow có năm node (khối trên sơ đồ) chính:
Chạy: Webhook (một địa chỉ URL, gọi vào là workflow chạy) để mình gọi khi cần; khi dùng thật, bạn thay bằng Schedule Trigger chạy mỗi sáng.
Đọc RSS blog: node RSS Read lấy 20 bài mới nhất từ
https://aidev.edu.vn/blog/rss.xml, mỗi bài có tiêu đề, link và đoạn tóm tắt.AI viết nháp: node Information Extractor nối Ollama, trả về hai trường
captionvàtieu_de_email.Kiểm nháp: node Code kiểm từng bản và gắn link có UTM.
Lưu bảng chờ duyệt: Data table
nhap_mxhtrong n8n, mỗi dòng có trạng thái "chờ duyệt" hoặc "cần sửa".
Trong node AI viết nháp, mình đặt system prompt (câu dặn chung gửi kèm mỗi lần gọi model) là "Bạn là người viết nội dung cho blog công nghệ AIDev. Viết đúng sự thật trong bài, không thêm số liệu, không hứa hẹn.", rồi mô tả hai trường cần lấy:
caption        Caption Facebook tiếng Việt 2 đến 4 câu giới thiệu bài, xưng "mình",
               chỉ dùng thông tin và con số có trong tóm tắt, không chèn link, không hashtag
tieu_de_email  Tiêu đề email tiếng Việt dưới 60 ký tự mời đọc bài
Mình cố ý bảo AI không chèn link. Link và mã UTM là thứ luật làm đúng 100%, nên node Code tự gắn vào cuối caption. Để AI viết link thì có ngày nó viết sai đường dẫn.
Bộ kiểm nháp kiểm những gì?
Node Code chạy sau bước AI và không gọi model nào, nên gần như không làm workflow chậm thêm:
const CAM = ['cam kết', '100%', 'tốt nhất', 'đảm bảo', 'số 1', 'duy nhất'];
const so = s => (s.match(/\d[\d.,]*/g) || []).map(x => x.replace(/[.,]+$/, '').replace(/[.,]/g, ''));
// với mỗi bản nháp: lấy tiêu đề + tóm tắt gốc của đúng bài đó
const soLa = [...new Set([...so(cap), ...so(tieuDe)])].filter(x => !soNguon.has(x));
if (cap.length > 500) loi.push('caption dài ' + cap.length + ' ký tự');
if (tieuDe.length > 60) loi.push('tiêu đề email dài ' + tieuDe.length + ' ký tự');
if (soLa.length) loi.push('số không có trong bài: ' + soLa.join(', '));
if (tuCam.length) loi.push('từ cấm: ' + tuCam.join(', '));
Bốn thứ được kiểm: con số nào trong caption mà không có trong bài gốc (dấu hiệu AI bịa số), độ dài, các từ hứa hẹn hay so sánh nhất mà luật quảng cáo dễ bắt lỗi, và link do AI tự chèn vào caption. File đầy đủ dài khoảng 25 dòng, gồm cả phần dựng dòng để lưu vào bảng.
AI viết 120 bản nháp thì đúng được bao nhiêu?
Mình chạy workflow 3 lần với gemma4:e2b và 3 lần với gemma4:e4b, hai model nhỏ của Gemma 4 lấy từ thư viện Ollama, cùng temperature (độ ngẫu nhiên khi model chọn chữ) 0,7 để câu chữ đa dạng hơn. Mỗi lần 20 bài, tổng 120 bản nháp:

gemma4:e2b | gemma4:e4b | |
|---|---|---|
Bản nháp | 60 | 60 |
Qua bộ kiểm (chờ duyệt) | 55 | 52 |
Tiêu đề email quá 60 ký tự | 4 | 6 |
Dính từ cấm (bắt đúng / bắt nhầm) | 1 (1 / 0) | 3 (0 / 3) |
Con số không có trong bài gốc | 0 | 0 |
Đọc tay 20 bản lần 1: sai ý / thêm ý | 0 / 1 | 1 / 0 |
Thời gian cho 20 bài, lần 2 và 3 | 14,7 và 14,5 giây | 23,3 và 22,6 giây |
Không bản nào bịa số. Có lẽ câu dặn "không thêm số liệu" trong system prompt và mô tả "chỉ dùng thông tin và con số có trong tóm tắt" đã giúp, và tóm tắt trong RSS của AIDev vốn nhiều số. Mình không thử bỏ hai câu đó đi nên không dám nói chắc.
Tiêu đề email dài là lỗi hay gặp nhất. AI được dặn "dưới 60 ký tự" nhưng vẫn viết 62 đến 67 ký tự, vì model nhỏ đếm ký tự kém. Đây là việc luật kiểm tốt hơn AI tự giữ.
Từ cấm thì ngược lại: chỉ 1 trong 4 lần là đúng chỗ, tiêu đề "Làm thế nào để chọn khóa học Python tốt nhất?". Ba lần còn lại là câu vô hại như "chạy file chấm bằng một lệnh duy nhất". Danh sách từ cấm là cách rẻ để người duyệt chú ý, chưa đủ để tự loại bản nháp.

Bộ kiểm bỏ sót gì?
Bộ kiểm tự động không bắt được lỗi sai ý. Mình đọc tay 40 bản của lần chạy đầu, đặt từng caption cạnh tóm tắt gốc. Một caption của gemma4:e4b sai ý mà vẫn được đánh "chờ duyệt":

Bài gốc so hai mức là 480p và 1280×960; caption gộp thành "480p (1280×960)", như thể đó là một mức. Mọi con số đều có trong bài nên bộ kiểm số không thấy gì. Một caption của gemma4:e2b thì thêm ý "cách tự học hiệu quả" mà bài khóa học Data Analyst không nói tới.
Ngoài lỗi, bản nháp của gemma4:e2b nhạt hơn. 9/60 caption mở bằng "Mình sẽ…" dù bài đã đăng, và nhiều caption bỏ mất con số cụ thể nhất của bài, như "173 tin tuyển dụng". gemma4:e4b giữ lại số cụ thể nhiều hơn, đổi lại chậm hơn khoảng 1,5 lần.

Kết luận của mình cho marketing automation AI kiểu này: để AI viết nháp, để luật kiểm phần đếm được (độ dài, link, số lạ, từ cấm), và để người duyệt đọc lại ý. Người duyệt đỡ được phần gõ từ đầu, nhưng vẫn phải đọc từng bản.
Lỗi mình gặp khi chạy workflow marketing
Ollama dừng thì cả lượt chạy hỏng, không bản nào vào bảng. Mình tắt Ollama (chạy dưới dạng container Docker) rồi gọi workflow. Webhook trả về sau 0,25 giây:
{"message":"Error in workflow"}
Màn Executions đánh đỏ node AI viết nháp và Ollama Chat Model, ngay sau khi RSS đã đọc xong 20 bài:

Dữ liệu lần chạy ghi loại lỗi NodeOperationError với thông báo:
fetch failed
Khi workflow chạy theo lịch mỗi sáng, không ai gọi webhook để thấy dòng lỗi này, và bảng chờ duyệt chỉ đơn giản là trống. Cách khắc phục: vào Settings của workflow, chọn Error Workflow là một workflow nhỏ gửi tin Telegram khi có lỗi, để biết ngay sáng hôm đó không có nháp.
Từ cấm bắt nhầm câu vô hại. Đây là đoạn caption bị gắn "cần sửa" vì chữ "đảm bảo":
Mình gợi ý 8 câu hỏi bạn nên hỏi trước khi đăng ký để đảm bảo khóa học có dạy SQL,
Python hoặc Power BI trên dữ liệu bẩn và có người chấm dự án cuối khóa.
Câu này không hứa gì với khách. Nên giữ danh sách từ cấm nhưng đổi cách dùng: bản dính từ cấm vẫn vào bảng chờ duyệt, chỉ kèm ghi chú để người duyệt nhìn kỹ, không bị loại tự động.
Thêm một điểm cần biết: RSS đổi giữa các lần chạy. Bài "Bài tập Python có lời giải" lên blog giữa các lượt chạy, nên có mặt ở các lượt sau mà không có ở lượt đầu. Nếu workflow chạy mỗi sáng, nên lưu link bài đã viết nháp để hôm sau bỏ qua, không viết lại bài cũ.
Khi nào không nên tự động marketing bằng AI?
Kênh chỉ có vài bài mỗi tháng. Viết 4 caption bằng tay nhanh hơn dựng và trông một workflow.
Không có ai duyệt. Không bản nào trong 120 bản mình chạy đủ an toàn để tự đăng: vẫn có tiêu đề so sánh nhất, câu sai ý, câu "Mình sẽ…" cho bài đã đăng.
Nội dung nhạy cảm: giá, khuyến mãi, cam kết giao hàng, khiếu nại. Một câu sai ở đây tốn tiền thật.
Bạn cần giọng văn riêng rõ rệt. Model nhỏ viết na ná nhau: trong 60 caption của gemma4:e4b, 41 caption mở bằng "Mình đã".
Câu hỏi thường gặp
AI được dùng trong marketing automation như thế nào?
Thường ở ba chỗ: viết nháp nội dung từ một nguồn có sẵn, xếp loại và tóm tắt phản hồi của khách, và đọc dữ liệu gõ tự do để chấm điểm khách tiềm năng. Phần gửi, lên lịch, gắn nhãn vẫn là luật cố định như marketing automation thường.
Ví dụ marketing automation đơn giản để bắt đầu là gì?
Bài blog mới thì gửi nháp caption vào một bảng, như workflow trong bài. Workflow này chạy được trên n8n tự host miễn phí, model chạy bằng Ollama trên máy của bạn, không cần tài khoản dịch vụ trả phí nào.
Có cần GPU để chạy AI viết nháp không?
Không bắt buộc. Trên GPU Tesla P40, 20 bài mất khoảng 15 giây. Máy chỉ có CPU thì chậm hơn nhiều: trong bài so sánh n8n, Make, Zapier, một bước AI cùng model mất khoảng 8,5 giây mỗi lần trên máy 8 vCPU. Nhân lên, 20 bài mất khoảng 3 phút; workflow chạy lúc 6 giờ sáng thì vẫn kịp.
Có nên để AI tự đăng bài lên fanpage không?
Mình không khuyên. Trong 120 bản nháp, bộ kiểm cho qua 107 bản, nhưng đọc tay vẫn thấy câu sai ý lọt qua. Cho AI viết nháp vào bảng, người bấm đăng.
Đọc tiếp
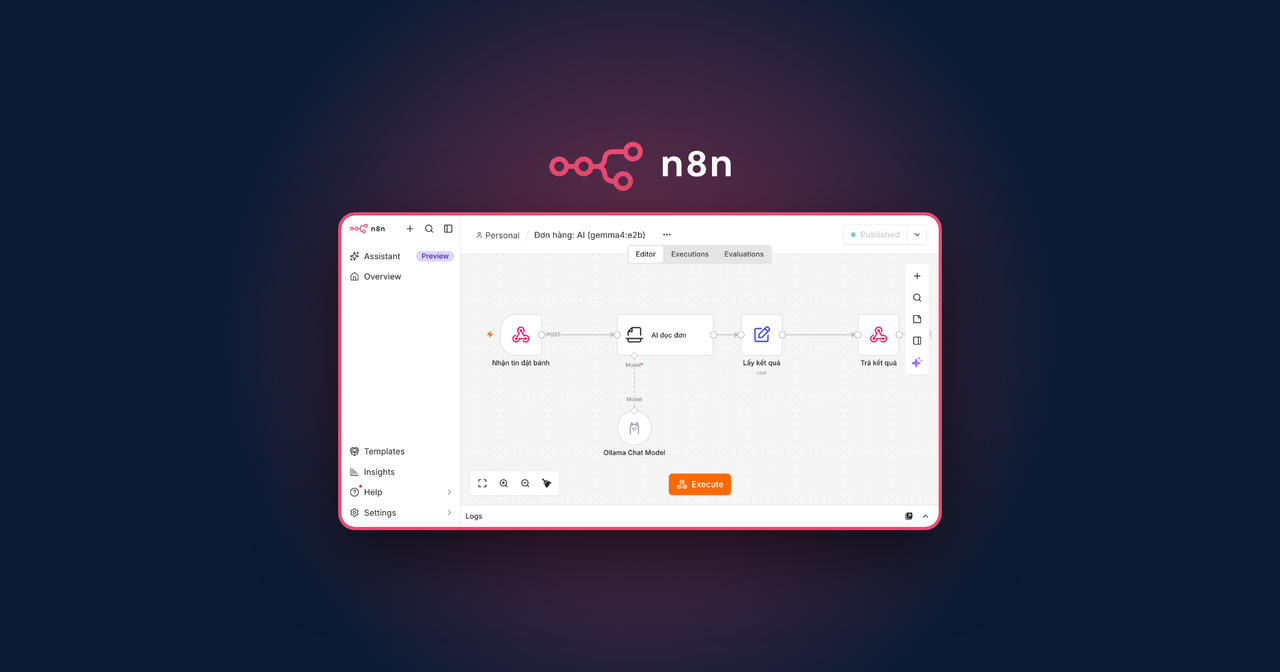
AI automation là gì: luật cố định và AI cùng đọc 40 tin đặt bánh.
n8n workflow mẫu: 6 template tiếng Việt, có bản tin AI tóm tắt và xếp loại phản hồi khách.
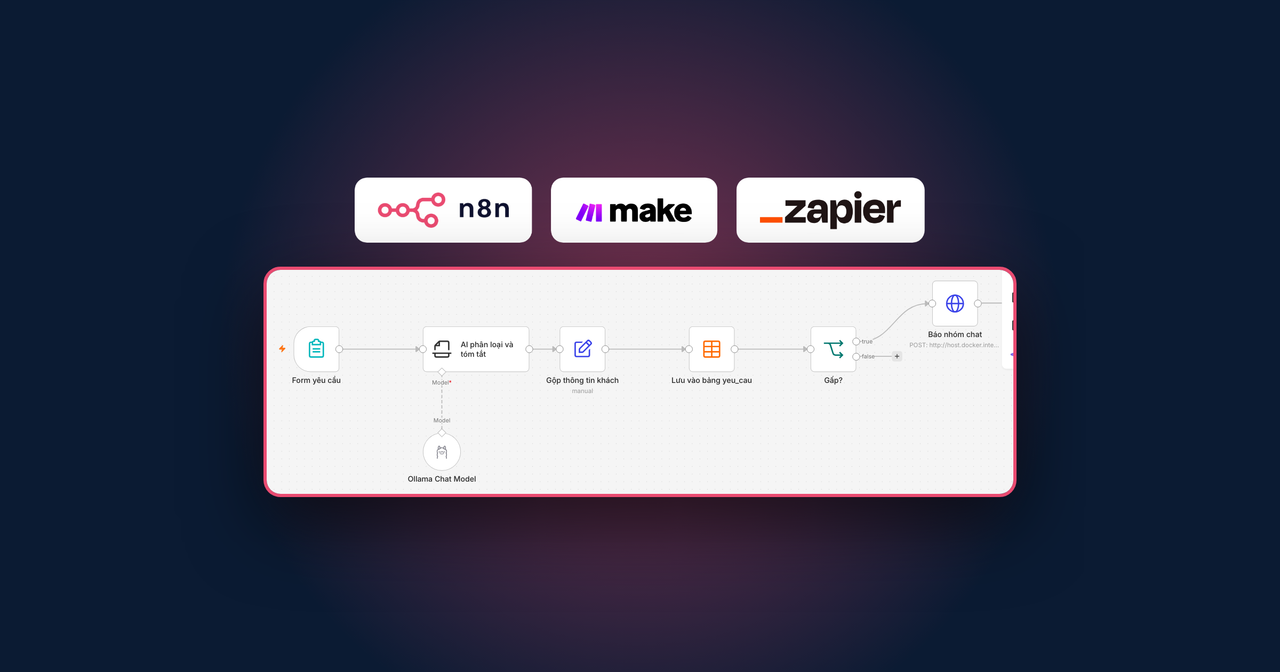
Công cụ AI automation: n8n, Make, Zapier so sánh: cùng một quy trình có bước AI, giá từng công cụ quy ra đồng.
n8n là gì: cài n8n và dựng workflow đầu tiên.
Muốn có workflow viết nháp, xếp loại bình luận hay báo cáo tuần chạy trên máy chủ của bạn, kèm bước kiểm và bảng duyệt như trong bài, AIDev nhận dựng workflow n8n cho đội marketing và bàn giao toàn quyền.
Chạy ngày 26/10/2026 trên máy AIDev Cloud Tesla P40 Standard (Xeon E5-2680 v4, 25 vCPU, 55GB RAM, GPU Tesla P40 24GB, Ubuntu 24.04.4, Docker 29.6.1): n8n 2.44.6, Ollama 0.40.11 (Docker), gemma4:e2b, gemma4:e4b. RSS blog AIDev đọc cùng ngày.
Chuyên mục
AI Automation
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.