Mục lục · 22
n8n là gì và làm được gì ngoài đời? Mình cài n8n 2.42.5 trên máy thuê, dựng 3 workflow chạy thật (tính tiền đơn hàng, lấy tỷ giá mỗi sáng, trợ lý chat cho quán phở) rồi đo tốc độ, chạy lặp để xem trợ lý AI tính tiền đúng được mấy lần và ghi lại mọi lỗi gặp phải.
n8n là phần mềm tự động hóa công việc bằng cách nối các khối gọi là node thành một workflow: nhận dữ liệu từ form, email, webhook, xử lý bằng code hoặc AI, rồi gửi kết quả sang Google Sheets, Telegram, cơ sở dữ liệu. Bạn kéo thả trên giao diện web, tự host miễn phí trên máy chủ của mình hoặc trả tiền dùng bản Cloud.
Những điều cần nắm trước khi đọc tiếp:
Bản ổn định mới nhất là n8n 2.42.5, ra ngày 08/10/2026. Bản 3.0 dự kiến ra trong tháng 10/2026 và sẽ bỏ cách cài bằng npm.
Cài bằng một dòng lệnh Docker mất 69 giây trên máy mình thuê, chiếm khoảng 0,9GB RAM lúc rảnh.
Tự host miễn phí cho việc của bạn và công ty bạn, nhưng không được mở n8n cho khách tự dựng workflow (giấy phép fair-code).
Trợ lý AI trong n8n chạy được bằng model trên máy riêng qua Ollama. Mình đo được một cái bẫy: để nguyên mặc định, mỗi câu trả lời mất 49 giây đến hơn 2 phút.
Model 9B tính tiền đơn hàng chỉ đúng 3 đến 7 trên 10 lần; model 26B đúng 10/10.
n8n là gì và tên n8n nghĩa là gì?
n8n đọc là "n-eight-n", viết tắt của "nodemation": "node" vì giao diện là các node nối với nhau và chạy trên Node.js, "mation" lấy từ automation. Người sáng lập Jan Oberhauser giải thích trong README trên GitHub rằng tên đầy đủ quá dài để gõ trong dòng lệnh, nên rút thành n8n.

Banner trên lấy từ README của n8n, màu hồng #EA4B71 là màu thương hiệu chính của họ. Repo n8n-io/n8n tạo từ tháng 6/2019, có 206.884 sao trên GitHub khi mình xem ngày 08/10/2026, và ra bản mới liên tục: riêng ngày 08/10 có bản ổn định 2.42.5, bản beta 2.43.2 và bản vá 1.123.84 cho nhánh cũ.
Trên bản 2.42.5 mình cài, danh sách node có 843 loại, trong đó 106 loại là trigger (khối khởi động workflow) và 106 loại thuộc nhóm AI như AI Agent, Chat Model, Memory, Vector Store. README của n8n thì ghi hơn 1.500 integration.
n8n tự host | n8n Cloud | Viết code tự động hóa | |
|---|---|---|---|
Ai giữ dữ liệu | Máy chủ của bạn | Máy chủ của n8n | Máy chủ của bạn |
Chi phí | Tiền máy chủ | Thuê bao tháng | Tiền máy chủ + công viết |
Cần biết code | Không bắt buộc, có node Code khi cần | Không bắt buộc | Có |
Ai lo cập nhật, sao lưu | Bạn | n8n | Bạn |
n8n dùng để làm gì trong công việc thật?
Những việc lặp đi lặp lại có quy tắc rõ ràng là chỗ n8n làm tốt nhất. Trong bài này mình dựng ba workflow và cho chạy thật:
Một hệ thống khác gửi đơn hàng qua webhook, n8n cộng tiền, tính VAT 8% rồi trả kết quả ngay.
8 giờ sáng hằng ngày, n8n tự lấy bảng tỷ giá Vietcombank, lọc 4 ngoại tệ và lưu vào bảng.
Trang chat cho một quán phở: khách hỏi giờ mở cửa, giá, phí giao, trợ lý trả lời bằng tiếng Việt bằng model chạy trên GPU riêng.
Những việc quen thuộc khác người ta hay giao cho n8n: chuyển đơn từ form sang Google Sheets rồi nhắn Telegram, gom email báo giá về một bảng, nhắc lịch hẹn, tóm tắt tài liệu bằng AI, đồng bộ khách hàng giữa hai phần mềm không nói chuyện được với nhau.

Workflow trên lấy file XML tỷ giá, đổi sang JSON, dùng node Code lọc USD, EUR, JPY, CNY rồi ghi vào Data table, một bảng dữ liệu có sẵn trong n8n. Lần chạy thử đầu tiên mất 2,26 giây và ghi đúng 4 dòng:

n8n hoạt động thế nào: workflow, node và trigger?
Một workflow là chuỗi node nối với nhau, dữ liệu chảy từ trái sang phải. Có ba loại node cần phân biệt:
Loại node | Việc nó làm | Ví dụ trong bài |
|---|---|---|
Trigger | Khởi động workflow | Webhook, Schedule (8h sáng), Chat Trigger |
Node xử lý | Biến đổi dữ liệu | Code, XML, Edit Fields, If |
Node dịch vụ | Đọc hoặc ghi sang nơi khác | HTTP Request, Data table, Google Sheets |
Node AI | Gọi model, nhớ hội thoại, dùng tool | AI Agent, Ollama Chat Model, Simple Memory |
Mỗi lần workflow chạy là một execution. n8n lưu lại dữ liệu từng node của mỗi execution, nên khi kết quả sai bạn mở đúng lần chạy đó ra xem node nào trả gì. Đây là phần mình dùng nhiều nhất khi gỡ lỗi trợ lý AI ở dưới.
Từ bản 2.x, workflow không còn công tắc Active như các hướng dẫn cũ. Bạn bấm Publish để đưa workflow vào chạy thật, nút chuyển thành Published.
n8n có miễn phí không?
Bản tự host miễn phí theo giấy phép Sustainable Use License, loại fair-code: xem được mã nguồn, dùng miễn phí, nhưng có giới hạn thương mại. n8n Cloud là bản trả phí theo tháng, do n8n vận hành.
Theo trang hỏi đáp giấy phép của n8n:
Được làm miễn phí | Không được làm |
|---|---|
Dùng n8n chạy việc của công ty bạn | Host n8n như dịch vụ cho khách tự dựng workflow |
Dự án cá nhân, học, nghiên cứu | Cho người dùng ngoài tự cấu hình workflow qua giao diện riêng, API hay MCP |
Dựng workflow cho khách trên máy của bạn, khách chỉ dùng | Fork mã nguồn làm sản phẩm tự động hóa riêng |
Thu phí dịch vụ dựng, bảo trì, đào tạo n8n | Bỏ thương hiệu n8n để bán lại |
Câu tóm gọn trong tài liệu: nếu workflow chỉ do bạn hoặc người trong tổ chức của bạn tạo và sửa, bạn dùng bản cộng đồng miễn phí. Tự host thì vẫn tốn tiền máy chủ; mình đo cấu hình nào chạy được ở phần dưới.
Cài n8n mất bao lâu?
Trên máy Ubuntu 24.04 có sẵn Docker, mình chạy lệnh cài một dòng mà tài liệu n8n đang khuyến nghị:
curl -fsSL https://get.n8n.io | sh
Script tạo thư mục n8n, sinh file cấu hình và mật khẩu nội bộ, kéo 5 container (n8n, task runner, sandbox cho trợ lý, máy tìm kiếm SearXNG) rồi khởi động. Cả quá trình mất 69 giây:

Bộ image tổng cộng 3,68GB, riêng image n8n 1,79GB. Lúc rảnh, cả 5 container dùng khoảng 0,9GB RAM, trong đó n8n khoảng 500MB.
Lệnh này phù hợp nhất để bắt đầu, nhưng nếu đặt n8n trên VPS có IP public thì đừng để nguyên. Mình phát hiện bản cài mặc định mở cổng 5678 cho cả Internet, ai vào trước người đó tạo được tài khoản quản trị. Cách khóa lại, gắn tên miền và HTTPS có trong bài tự host n8n bằng Docker trên VPS.
Mở http://localhost:5678, việc đầu tiên là tạo tài khoản owner (email, tên, mật khẩu ít nhất 8 ký tự có số và chữ hoa). Sau đó n8n hỏi vài câu khảo sát, bỏ qua được.
Workflow đầu tiên: webhook tính tiền đơn hàng
Workflow đơn giản nhất mà vẫn có ích: nhận đơn qua webhook, tính tiền bằng node Code, trả kết quả lại cho bên gọi.

Node Code chạy JavaScript. Đoạn mình dùng để cộng tiền và tính VAT 8%:
const don = $input.first().json.body;
const tamTinh = don.mon.reduce((s, m) => s + m.gia * m.sl, 0);
const vat = Math.round(tamTinh * 0.08);
return [{ json: { khach: don.khach, so_mon: don.mon.length, tam_tinh: tamTinh, vat_8: vat, tong: tamTinh + vat } }];
Mình gọi thử bằng curl khi chưa bấm Publish và nhận ngay lỗi 404, vì URL production chỉ hoạt động sau khi workflow được Publish:
{"code":404,"message":"The requested webhook \"POST don-hang\" is not registered.","hint":"The workflow must be active for a production URL to run successfully. ..."}
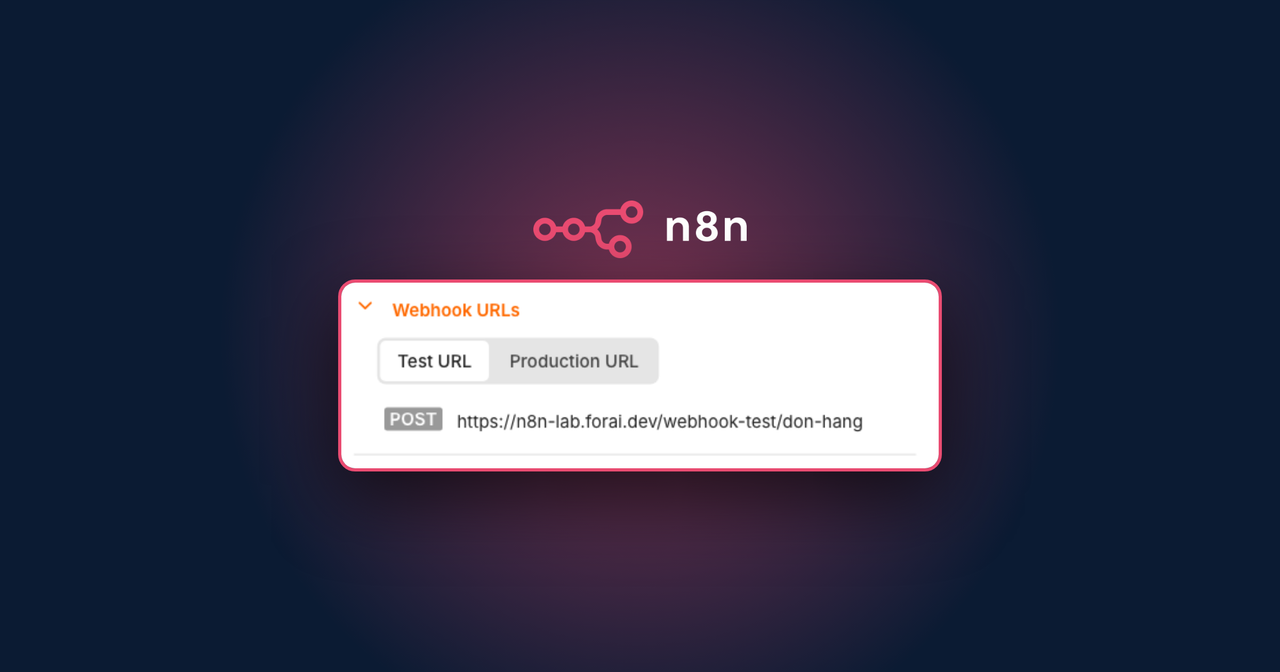
Bấm Publish rồi gọi lại, đơn 2 bát phở bò giá 55.000đ trả về đúng 118.800đ đã gồm VAT:

Mỗi workflow có hai URL: webhook-test chỉ chạy khi bạn đang bấm "Listen for test event" trong editor, còn webhook là URL thật sau khi Publish. Nếu gửi nhầm URL test cho hệ thống khác, webhook chỉ chạy được trong lúc bạn đang mở editor.
n8n chạy nhanh đến đâu và cần máy mạnh cỡ nào?
Mình bắn 1.000 request vào workflow tính tiền ở trên, 20 luồng cùng lúc, trên nhiều cấu hình. Cấu hình nhỏ được giới hạn bằng docker --cpus và --memory để giống VPS giá rẻ:

Cấu hình | Request/giây | Trễ p95 | RAM cao nhất |
|---|---|---|---|
1 CPU, 1GB RAM | 10 | 2,5 giây | 626MB |
2 CPU, 2GB RAM | 18 | 1,3 giây | 626MB |
25 nhân, SQLite (bộ cài get.n8n.io) | 37 | 0,6 giây | khoảng 0,9GB cả bộ |
25 nhân, Postgres | 46 | 0,48 giây | Postgres thêm 58MB |
Cả 1.000 request đều thành công ở mọi cấu hình, kể cả 1 CPU 1GB không bị tràn RAM. Với n8n, thêm CPU có tác dụng hơn thêm RAM. Workflow ít việc như nhắc lịch, đồng bộ đơn thì VPS 1 CPU 1GB đủ dùng; nếu nhận webhook dồn dập hay chạy AI thì cần máy mạnh hơn. Chú ý tài liệu n8n ghi cần ít nhất 4GB RAM, 2 vCPU khi dùng cả bộ có sandbox cho trợ lý.
Thêm AI vào n8n: trợ lý chạy model trên GPU riêng
n8n có node AI Agent: bạn gắn một Chat Model (OpenAI, Gemini, Claude hoặc model chạy trên máy bằng Ollama), thêm Memory để nhớ hội thoại và Tool để trợ lý gọi khi cần. Mình dùng Ollama với model qwen3.5:9b và gemma4:26b trên card Tesla P40 24GB, không gửi dữ liệu ra ngoài.
Lỗi đầu tiên gặp ngay khi nối: n8n chạy trong Docker còn Ollama chạy trên máy chủ, nên 127.0.0.1 trong container là chính container chứ không phải máy chủ:
wget: can't connect to remote host (127.0.0.1): Connection refused
wget: bad address 'host.docker.internal:11434'
Cách sửa mình dùng: cho Ollama nghe ở mọi địa chỉ bằng biến OLLAMA_HOST=0.0.0.0:11434, thêm dòng extra_hosts cho service n8n trong compose.yml, rồi điền http://host.docker.internal:11434 vào credential Ollama:
  n8n:
    extra_hosts:
      - host.docker.internal:host-gateway

Máy chủ của bạn có IP public thì chặn cổng 11434 bằng firewall, vì Ollama không có mật khẩu.
Cái bẫy thinking: mỗi câu trả lời mất 2 phút
Node Ollama Chat Model trong n8n 2.42.5 để mặc định Enable Thinking bật và Context Length 2048. Với model có chế độ suy nghĩ như qwen3.5, trợ lý viết hàng nghìn token suy nghĩ trước khi trả lời. Ba câu hỏi đầu tiên mất 48,8 giây, 81,5 giây, 132,5 giây, và câu thứ ba trả về rỗng vì phần suy nghĩ vượt quá 2.048 token context.

Mở node Ollama Chat Model, bấm Add Option, tắt Enable Thinking và tăng Context Length lên 8192. Sau khi sửa, mỗi câu còn khoảng 3 giây, câu đầu 7 giây vì phải nạp model lên GPU.
Trợ lý có tính tiền đúng không?
Mình dựng trang chat cho một quán phở giả định: phở bò 55.000đ, phở gà 50.000đ, quẩy 5.000đ, phí giao 15.000đ, tất cả ghi trong lời dặn hệ thống. Khách hỏi 3 câu nối tiếp: giờ mở cửa, đặt 2 phở bò và 2 quẩy giao cách 3km hết bao nhiêu, thêm 1 phở gà thì tổng bao nhiêu. Đáp án đúng là 135.000đ và 185.000đ.

Lần đầu với qwen3.5:9b, trợ lý bịa ra "miễn phí giao hàng" và tính 125.000đ. Mình thử thêm tool Calculator, rồi viết riêng một tool tính tiền có sẵn bảng giá, mỗi cấu hình chạy 5 lượt hội thoại và chấm tự động:

Mở từng execution ra xem thì thấy nguyên nhân: tool luôn trả đúng con số khi được gọi, nhưng model 9B thường không chịu gọi tool. Ở câu đặt món đầu tiên, nó chỉ gọi tool 1 trong 6 lần. Màn hình Logs của n8n cho thấy rõ Ollama được gọi 2 lần, Calculator chỉ 1 lần:

Đổi sang gemma4:26b thì đúng 10/10 ở cả ba cấu hình, gọi tool đủ 10/10 lần cần thiết, và còn nhanh hơn: 57,6 token/giây so với 29,8 của qwen3.5:9b trên cùng card P40. Bài học mình rút ra: trợ lý AI làm tốt phần trò chuyện, còn chuyện tiền thì để node Code tính hoặc dùng model đủ lớn, và luôn chạy thử nhiều lượt trước khi cho khách dùng.
Muốn chạy model 26B như vậy cần card khoảng 24GB VRAM. Bảng VRAM từng model có trong bài AI local: chạy LLM và AI tạo ảnh trên máy bạn. Nếu chưa có card, máy GPU của AIDev Cloud cho thuê theo giờ; máy Tesla P40 mình dùng trong bài có giá 7.000 đồng/giờ ngày 08/10/2026.
n8n 3.0 sắp ra có gì cần biết?
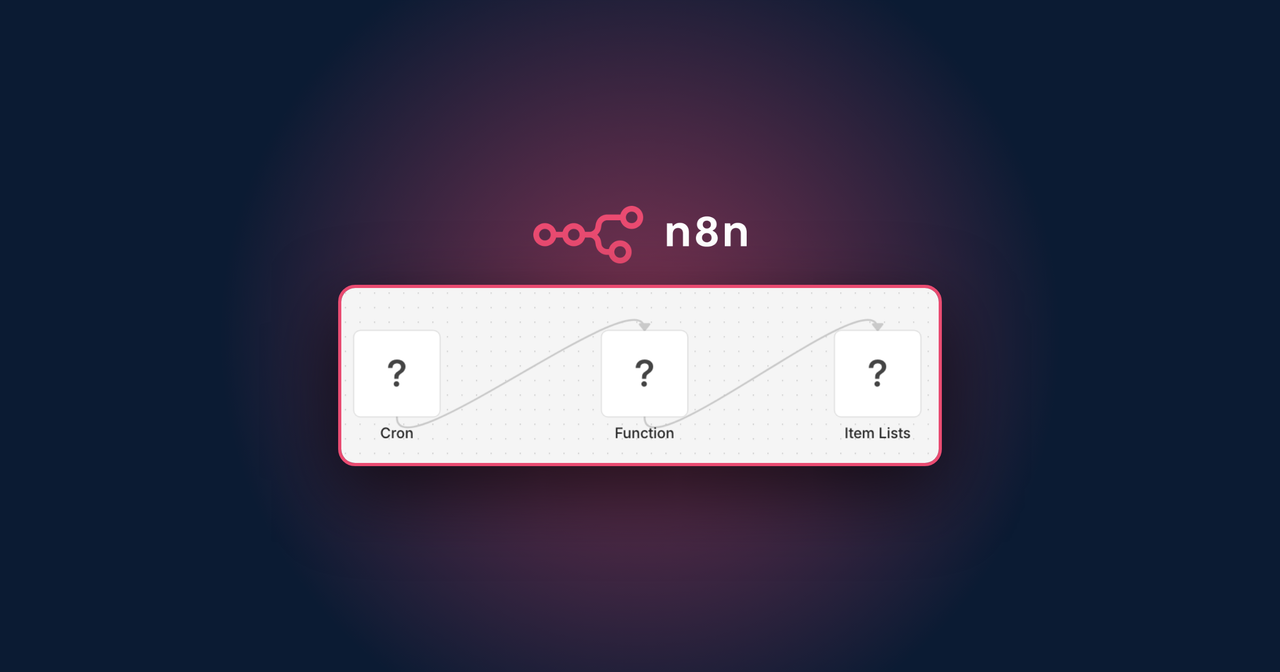
Theo trang thay đổi của bản 3.0, n8n 3.0 dự kiến ra trong tháng 10/2026, chỉ phát hành qua Docker (bỏ npm install n8n) và xóa hàng loạt node cũ như Cron, Function, Item Lists, Read PDF. Ngày 08/10/2026, bản ổn định vẫn là 2.42.5.
Bản 2.x đã có sẵn trang Settings → Migration report để kiểm tra trước. Mình tạo thử một workflow dùng Cron, Function, Item Lists, trang này báo đủ 3 vấn đề kèm node thay thế:

Mình đã chạy thử image v3-nightly trên bản sao dữ liệu: các node cũ hiện thành dấu hỏi và không Publish được. Chi tiết trong bài n8n 3.0 có gì mới.
Những lỗi hay gặp khi mới dùng n8n
Lỗi | Nguyên nhân | Cách sửa |
|---|---|---|
| Workflow chưa Publish, hoặc gọi URL production khi chỉ đang test | Bấm Publish, dùng đúng URL |
|
|
|
Trợ lý trả lời rất chậm hoặc rỗng | Node Ollama bật thinking, context 2048 | Tắt Enable Thinking, Context Length 8192 |
Trợ lý tính sai tiền | Model nhỏ không gọi tool | Tính bằng node Code hoặc dùng model lớn hơn |
URL webhook hiện | Chưa đặt địa chỉ thật | Đặt |
Mất credential sau khi chuyển máy | Không mang theo khóa mã hóa | Chép nguyên volume dữ liệu |
Hai lỗi mình gặp khi chuyển n8n sang máy mới và khi thử bản 3.0, thông báo nguyên văn:
Credentials could not be decrypted. The likely reason is that a different "encryptionKey" was used to encrypt the data.
{"code":0,"message":"Unrecognized node type: n8n-nodes-base.cron"}
Lỗi đầu là do import credential sang máy khác mà không mang theo khóa mã hóa; lỗi sau là workflow còn node Cron khi chạy bản 3.0. Cách xử lý từng bước có trong bài tự host n8n trên VPS.
Khi nào không nên dùng n8n?
Việc chỉ chạy một lần hoặc vài lần mỗi năm. Viết tay hay dùng bảng tính còn nhanh hơn dựng workflow.
Bạn muốn bán một sản phẩm cho phép khách tự dựng workflow. Giấy phép bản miễn phí không cho phép, phải mua bản Enterprise.
Không ai trong nhóm theo dõi được workflow khi lỗi. Tự host nghĩa là bạn tự lo sao lưu, cập nhật, khóa bảo mật; không có người lo thì nên dùng n8n Cloud.
Hệ thống cần xử lý hàng trăm request mỗi giây liên tục. Một máy n8n mình đo được khoảng 46 request/giây, muốn hơn phải dùng chế độ queue nhiều máy.
Câu hỏi thường gặp
n8n đọc thế nào?
Đọc là "n-eight-n" (en-ết-en), viết tắt của "nodemation", theo giải thích của người sáng lập trên GitHub.
Không biết code có dùng được n8n không?
Được, phần lớn node chỉ cần điền form và kéo thả. Biết một chút JavaScript thì làm được nhiều hơn nhờ node Code, như phép tính tiền trong bài.
n8n có tiếng Việt không?
Giao diện n8n là tiếng Anh. Nội dung workflow, tên node, dữ liệu, câu trả lời của trợ lý thì dùng tiếng Việt bình thường, như các ví dụ trong bài.
n8n có chạy trên Windows được không?
Được, qua Docker Desktop. Tài liệu n8n khuyên dùng WSL và để thư mục dự án trong ổ của WSL, không đặt dưới /mnt/c, vì chép qua lại giữa hai hệ thống file chậm và dễ lỗi quyền.
n8n có AI không?
Có. Ngoài node AI Agent và các Chat Model, bản 2.x còn có n8n Assistant (đang ở dạng Preview) và MCP server để các trợ lý như Claude, Cursor gọi workflow của bạn. Mình bật thử MCP trên bản 2.42.5: có 50 tool, gọi được workflow tính tiền từ xa qua HTTPS. Cách nối Claude Code và nhờ nó dựng workflow có trong bài n8n MCP.
Đọc tiếp
Hiểu n8n là gì rồi thì bước tiếp theo tùy bạn định dùng nó ở đâu:
Tự host n8n bằng Docker trên VPS từ A đến Z: khóa cổng, tên miền, HTTPS, chạy khi không có IP tĩnh, sao lưu và chuyển máy.
n8n 3.0 có gì mới: danh sách node bị xóa, cách dùng Migration report, thử bản nightly.
n8n MCP: cho Claude Code, Cursor gọi và dựng workflow trên n8n của bạn.
Supabase là gì, tự host bằng Docker: backend Postgres tự host để n8n ghi dữ liệu vào.
Ollama là gì: chạy model trên máy riêng để trợ lý n8n không gửi dữ liệu ra ngoài.
Muốn tự viết những trợ lý như vậy bằng Python thay vì kéo thả, xem lộ trình AI Engineer từ số 0 của AIDev.
Mọi số đo trong bài chạy trên máy Tesla P40 24GB của AIDev Cloud ngày 08 và 09/10/2026 (n8n 2.42.5, Ollama 0.40.1, Docker 29.6.1, Ubuntu 24.04). Giá thuê máy ghi theo ngày viết bài.
Chuyên mục
AI Automation
Về tác giả
Founder AIDev
Thạc sĩ AI MSE, tốt nghiệp thủ khoa với điểm 9,4/10. Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên. Sáng lập AIDev và VietPlatform, xây hệ thống AI cho doanh nghiệp. Anh trực tiếp biên soạn và giảng dạy toàn bộ lộ trình AI Engineer.