Ollama
Danh sách bài viết
GPU là gì và vì sao AI cần nó? Cùng một phép nhân ma trận, cùng một chatbot AI chạy trên CPU Xeon, Tesla P40, RTX 3090 và Apple M4 Pro cho thấy GPU nhanh hơn CPU từ khoảng 6 đến hơn 30 lần, kèm cách xem máy bạn có GPU gì và cần bao nhiêu VRAM.
Cài Ollama trên Linux, Windows và Docker, làm thật trên hai máy thuê ngày 10/10/2026: lệnh nào, mất bao lâu, chạy nhanh đến đâu, vì sao container mới nạp model mất gần một phút và cách sửa, cổng 11434 mở ra ngoài khi nào. macOS ghi theo tài liệu chính thức.
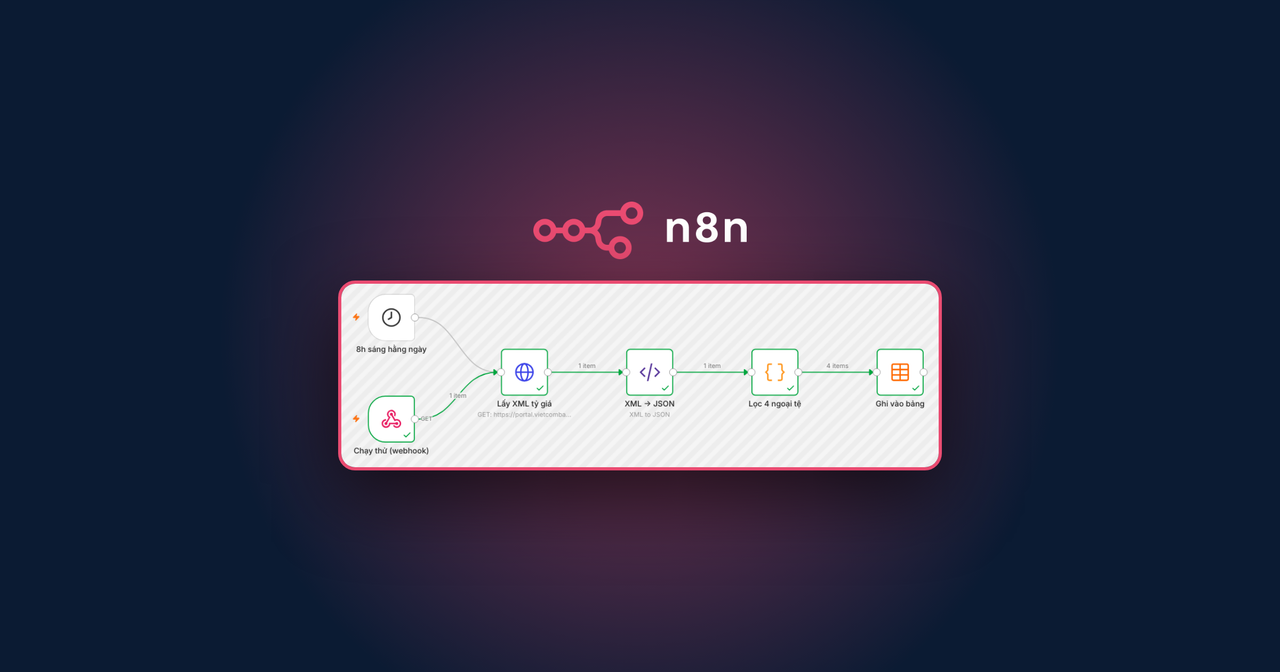
n8n là gì và làm được gì ngoài đời? Mình cài n8n 2.42.5 trên máy thuê, dựng 3 workflow chạy thật (tính tiền đơn hàng, lấy tỷ giá mỗi sáng, trợ lý chat cho quán phở) rồi đo tốc độ, chạy lặp để xem trợ lý AI tính tiền đúng được mấy lần và ghi lại mọi lỗi gặp phải.
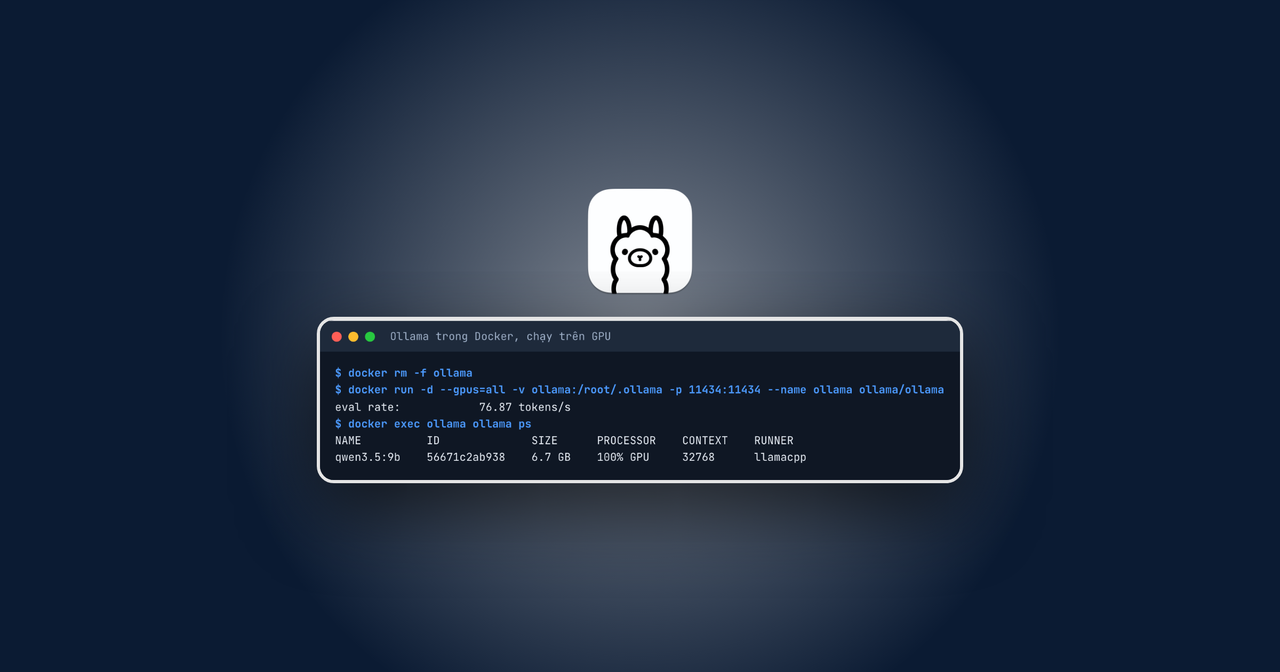
Ollama là gì khi chạy thật trên GPU? Số đo của 5 model trên RTX 3090: tốc độ sinh chữ, VRAM cần, chuyện gì xảy ra khi thiếu VRAM, cách gọi API giống OpenAI và 6 lỗi mình gặp khi cài trên Ubuntu, kèm lệnh và output thật.
AI local có đáng tự làm không? Mình đo 9 model chat và tạo ảnh trên RTX 3090 để trả lời ba câu hỏi: cần GPU bao nhiêu VRAM, chạy bằng CPU chậm đến đâu, và nên tự mua máy hay thuê GPU theo giờ, kèm phép tính chi phí điện và tiền máy.