Mục lục · 17
GPU là gì và vì sao AI cần nó? Cùng một phép nhân ma trận, cùng một chatbot AI chạy trên CPU Xeon, Tesla P40, RTX 3090 và Apple M4 Pro cho thấy GPU nhanh hơn CPU từ khoảng 6 đến hơn 30 lần, kèm cách xem máy bạn có GPU gì và cần bao nhiêu VRAM.
GPU (Graphics Processing Unit, bộ xử lý đồ họa) là con chip có hàng nghìn lõi nhỏ, chuyên làm cùng lúc rất nhiều phép tính giống nhau. CPU thì ngược lại, có ít lõi nhưng mỗi lõi mạnh và linh hoạt, hợp với việc tuần tự. GPU sinh ra để vẽ hình, vì mỗi khung hình là hàng triệu điểm ảnh tính theo cùng một công thức. AI cũng cần đúng kiểu sức mạnh đó.
Mấy điều cần nắm trước khi đọc tiếp:
GPU là con chip. Card đồ họa là cả tấm mạch gồm GPU, bộ nhớ riêng (VRAM), tản nhiệt và cổng xuất hình.
Máy tính nào cũng cần CPU. GPU là bộ đồng xử lý, CPU giao việc nặng cho nó.
Với AI, hai con số quan trọng nhất của GPU là sức tính và băng thông bộ nhớ. Dung lượng VRAM quyết định model lớn cỡ nào chạy được.
Ngày 11/10/2026, mình thuê hai máy GPU (RTX 3090 và Tesla P40) rồi chạy cùng một phép tính và cùng một model AI trên CPU lẫn GPU. Mình cũng chạy lại trên máy Mac M4 Pro để so. Số đo nằm ở phần dưới.
GPU là gì, khác CPU thế nào?
So một CPU máy chủ với một GPU chơi game cũ cho dễ thấy. Thông số lấy từ trang Intel ARK và whitepaper GA102 của NVIDIA:
CPU Xeon E5-2680 v4 | GPU RTX 3090 | |
|---|---|---|
Số lõi | 14 lõi, 28 luồng (máy thuê là máy ảo 25 vCPU chạy trên chip này) | 10.496 lõi CUDA |
Băng thông bộ nhớ | 76,8 GB/s | 936 GB/s |
Bộ nhớ | RAM của máy | 24GB VRAM riêng |
Giỏi việc gì | Rẽ nhánh, xử lý tuần tự, chạy hệ điều hành | Một phép tính lặp lại trên rất nhiều dữ liệu |
Lõi GPU không thông minh bằng lõi CPU. Mỗi lõi chỉ làm phép nhân cộng đơn giản, nhưng có hàng nghìn lõi chạy cùng lúc. Việc nào chia được thành hàng nghìn phần nhỏ giống nhau thì GPU thắng. Việc nào phải làm từng bước, bước sau chờ kết quả bước trước, thì CPU vẫn nhanh hơn.
Chữ "GPU" được NVIDIA phổ biến năm 1999, khi hãng quảng bá GeForce 256 là "GPU đầu tiên trên thế giới". Từ khoảng năm 2007, khi CUDA ra đời, GPU bắt đầu được dùng rộng rãi cho tính toán khoa học, rồi đến deep learning.
Vì sao AI cần GPU?
Mạng neural, từ model nhận dạng ảnh đến LLM (mô hình ngôn ngữ lớn) như ChatGPT, về bản chất là các phép nhân ma trận khổng lồ lặp đi lặp lại. Nhân hai ma trận 4096×4096 cần khoảng 137 tỷ phép tính. Kết quả có 16,7 triệu ô, và mỗi ô tính độc lập với các ô khác. Đây đúng là kiểu việc GPU làm giỏi nhất.
Mình viết một script PyTorch nhân hai ma trận như vậy rồi chạy trên từng thiết bị, lấy trung vị nhiều lần chạy:

RTX 3090 nhanh gấp khoảng 31 lần CPU Xeon 25 vCPU trên cùng máy. Khi chuyển sang số thực 16 bit (float16, kiểu số các model AI hay dùng), RTX 3090 vọt lên 73,1 TFLOPS nhờ Tensor Core, nhanh gấp khoảng 90 lần CPU. Tesla P40 thì không được như vậy: float16 chỉ đạt 10,0 TFLOPS, nhỉnh hơn float32 (8,1) một chút, vì chip đời 2016 này không có Tensor Core.
Với một lớp mạng xử lý ảnh (lớp tích chập, 64 ảnh 224×224 mỗi lượt, vẫn là float32), CPU Xeon xử lý 949 ảnh mỗi giây, còn RTX 3090 xử lý 46.124 ảnh mỗi giây, gấp khoảng 49 lần.
GPU nhanh hơn CPU bao nhiêu khi chạy chatbot AI?
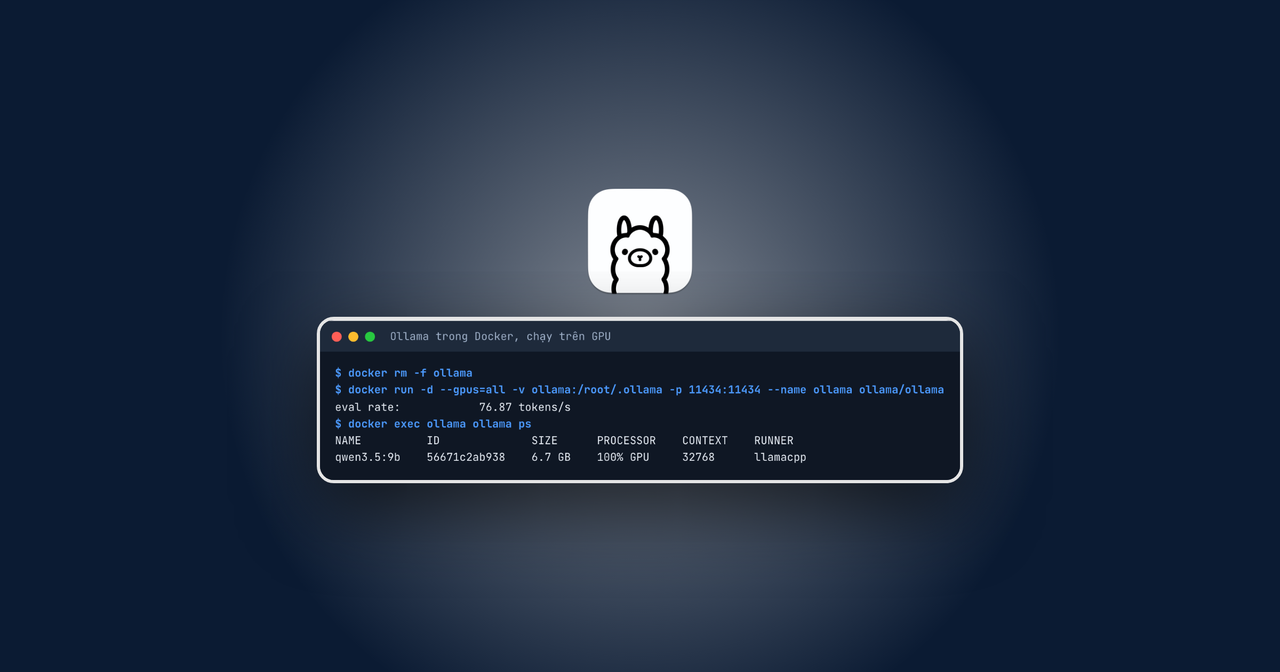
Con số TFLOPS hơi xa người dùng, nên mình đo thêm một việc quen hơn: chạy model qwen3.5:9b bằng Ollama, hỏi cùng một câu "GPU là gì và vì sao AI cần GPU?" và đo tốc độ sinh chữ. Chạy CPU thì vẫn dùng đúng máy đó, chỉ ép Ollama không dùng GPU (num_gpu: 0). Số trong biểu đồ là trung bình các lần chạy sau khi model đã nạp xong.

Token là mẩu chữ model sinh ra mỗi bước, thường ngắn hơn một từ. Ở 4,6 token mỗi giây, câu trả lời 256 token mất gần một phút trên CPU. Trên RTX 3090, cùng câu trả lời đó hiện ra trong khoảng 3,4 giây. Lệnh ollama ps cho thấy rõ model đang chạy ở đâu:

Lúc sinh chữ, RTX 3090 chỉ bận khoảng 61%, Tesla P40 bận 87%. Sinh từng token không cần nhiều phép tính, mà cần đọc toàn bộ model từ bộ nhớ ra cho mỗi token. Vì vậy tốc độ chatbot đi theo băng thông bộ nhớ nhiều hơn theo TFLOPS:
Thiết bị | Băng thông công bố | Mình đo (copy 1GB) | Sinh chữ qwen3.5:9b |
|---|---|---|---|
CPU Xeon E5-2680 v4 (máy ảo 25 vCPU) | 76,8 GB/s | 24 GB/s | 4,6 token/s |
GPU Tesla P40 | 346 GB/s | 242 GB/s | 30,4 token/s |
GPU RTX 3090 | 936 GB/s | 837 GB/s | 76,8 token/s |
Đây cũng là lý do VRAM quan trọng. Model phải nằm gọn trong VRAM thì GPU mới đọc nhanh được. Model lớn hơn VRAM thì một phần phải nằm ở RAM thường và do CPU xử lý, tốc độ tụt mạnh.
GPU bao nhiêu VRAM là đủ để chạy AI?
Câu này không có con số chung, vì phụ thuộc model và độ dài ngữ cảnh (context). Ngày 08/10/2026 mình đo 5 model phổ biến bằng Ollama 0.40.0 trên một máy RTX 3090 khác, context mặc định 32.768 token, đọc VRAM bằng nvidia-smi:
Model | Kiểu | VRAM khi chạy | Tốc độ sinh chữ |
|---|---|---|---|
qwen3.5:9b | 9 tỷ tham số | 7,4GB | 76,5 token/s |
llama3.1:8b | 8 tỷ tham số | 8,9GB | 133,7 token/s |
gpt-oss:20b | MoE 20 tỷ | 13,1GB | 142,2 token/s |
gemma4:26b | MoE 26 tỷ | 19,4GB | 168,9 token/s |
qwen3.8:27b | 27 tỷ tham số | 19,5GB | 60,1 token/s |
Context ăn VRAM đáng kể. Bảng trên đọc bằng nvidia-smi, con số này tính cả phần bộ nhớ CUDA giữ sẵn nên cao hơn số của ollama ps một chút. Trên Tesla P40, Ollama tự chọn context 4.096 và qwen3.5:9b chỉ chiếm 5,6GB. Trên RTX 3090 với context 32.768, cùng model đó chiếm 6,7GB theo ollama ps. Đọc từ bảng trên: card 8GB chạy được model cỡ 8 đến 9 tỷ tham số nếu để context ngắn (qwen3.5:9b ở context 4.096 chỉ cần 5,6GB), card 16GB chạy được loại 20 tỷ, còn model 26 đến 27 tỷ cần card trên 20GB, thực tế là loại 24GB.
Cột tốc độ cũng cho thấy model to hơn chưa chắc chậm hơn. gemma4:26b là kiểu MoE, mỗi token chỉ dùng một phần nhỏ tham số, nên nhanh gấp gần ba lần qwen3.8:27b dù chiếm VRAM gần bằng nhau.
Máy Mac và laptop có GPU không?
Có, nhưng khác loại. Phần lớn laptop và mọi máy Mac đời mới dùng GPU tích hợp (iGPU), nằm chung con chip với CPU và dùng chung RAM của máy. Card rời như RTX 3090 có VRAM riêng và băng thông cao hơn nhiều.
Mac dòng chip M là trường hợp đặc biệt: bộ nhớ chung có băng thông khá cao (M4 Pro được Apple công bố 273 GB/s), nên có thể chạy model nhỏ. Trên Mac mình chỉ đo phép nhân ma trận: GPU M4 Pro đạt 5,8 TFLOPS, chừng một phần tư RTX 3090. CPU M4 Pro đạt 2,7 TFLOPS, hơn ba lần CPU Xeon máy chủ đời 2016 mình thuê.
Xem máy bạn có GPU gì bằng cách nào?
Windows: mở Task Manager (Ctrl + Shift + Esc), tab Performance, các mục GPU 0, GPU 1 hiện tên chip và dung lượng bộ nhớ. Hoặc gõ
dxdiagở Start, xem tab Display.macOS: menu Apple > About This Mac hiện tên chip. Muốn biết GPU có bao nhiêu lõi thì dùng Terminal.
Linux hoặc máy thuê có card NVIDIA: chạy
nvidia-smi, lệnh này đi kèm driver.
Trên máy Mac của mình, lệnh system_profiler cho biết GPU tích hợp của chip M4 Pro có 20 lõi, nằm sẵn trong chip (Bus: Built-In) và dùng Metal 4, nền tảng đồ họa của Apple mà PyTorch gọi qua backend MPS:
system_profiler SPDisplaysDataType | head -10

Trên máy có card NVIDIA, nvidia-smi là lệnh đầu tiên nên chạy:
nvidia-smi

Đọc ba chỗ: tên card, Memory-Usage (VRAM đã dùng trên tổng) và Pwr:Usage/Cap (công suất đang dùng trên mức tối đa). Card đang rảnh như trên chỉ ăn 21W. Khi chạy chatbot, mình đo được khoảng 310W.
GPU đời cũ có còn dùng cho AI được không?
Dùng được, nhưng phải để ý phần mềm. Tesla P40 có 24GB VRAM, tốc độ chatbot vẫn gấp khoảng 6,5 lần CPU cùng máy (30,4 so với 4,7 token mỗi giây). Có điều phần mềm AI mới đang bỏ dần các đời card cũ. Mình cài PyTorch bản mới nhất bằng pip install torch trên máy P40 và gặp lỗi ngay khi chạy:
torch.AcceleratorError: CUDA error: no kernel image is available for execution on the device

Bản PyTorch mặc định dựng cho CUDA 13 chỉ hỗ trợ từ đời Turing (compute capability 7.5) trở lên. P40 thuộc đời Pascal (6.1). Cách sửa nằm ngay trong cảnh báo: cài lại đúng phiên bản đó, bản dựng cho CUDA 12.6:
pip install --force-reinstall torch==2.14.1 --index-url https://download.pytorch.org/whl/cu126
Sau lệnh này script chạy bình thường. Nhưng đây là giải pháp tạm. Theo thông báo của PyTorch ngày 04/09/2026, 2.14 là bản cuối có bản dựng cho CUDA 12.x. Từ PyTorch 2.15, các đời Maxwell, Pascal, Volta không còn bản cài sẵn nữa. Ai định mua card cũ giá rẻ để học AI nên tính chuyện này.
Học AI có bắt buộc phải có GPU không?
Không bắt buộc lúc đầu. Học Python, phân tích dữ liệu, machine learning cổ điển với scikit-learn thì CPU laptop là đủ. GPU cần khi bạn huấn luyện mạng neural, chạy model tạo ảnh như ComfyUI, hoặc chạy LLM trên máy cho nhanh.
Khi tới bước đó mà máy chưa có card rời, thuê GPU theo giờ thường rẻ hơn mua card chỉ để thử. Bài AI Local có phép tính mua hay thuê chi tiết.
Khi nào chưa cần GPU?
Bạn chỉ dùng ChatGPT, Gemini, Claude trên web: model chạy trên GPU của nhà cung cấp, máy bạn không cần gì thêm.
Bạn làm bảng tính, phân tích dữ liệu vài trăm nghìn dòng, train model scikit-learn: CPU xử lý tốt, GPU không giúp được mấy.
Model bạn cần lớn hơn VRAM của mọi card trong tầm tiền: lúc đó gọi API hoặc thuê máy GPU lớn hợp lý hơn mua card.
Câu hỏi thường gặp
GPU có phải là card đồ họa không?
Không hẳn. GPU là con chip xử lý, card đồ họa là cả tấm mạch chứa GPU, VRAM, tản nhiệt và cổng xuất hình. Người Việt hay gọi card đồ họa là "card màn hình" hoặc "VGA". VGA thật ra là tên một chuẩn cổng xuất hình cũ.
iGPU là gì?
iGPU (integrated GPU) là GPU tích hợp, nằm chung con chip với CPU và dùng chung RAM hệ thống. Laptop văn phòng và máy Mac dùng loại này. Card rời (dGPU) là GPU nằm trên card riêng, có VRAM riêng, mạnh hơn và tốn điện hơn.
VRAM là gì, chạy AI cần bao nhiêu?
VRAM là bộ nhớ riêng trên card đồ họa, nơi model AI phải nằm khi chạy trên GPU. Model qwen3.5:9b mình dùng chiếm 5,6GB ở context 4.096 nên vừa card 8GB. Model càng nhiều tham số thì càng cần nhiều VRAM, 24GB như RTX 3090 chạy được model cỡ khoảng 27 tỷ tham số đã nén.
Vì sao GPU NVIDIA phổ biến cho AI?
Vì các phần mềm AI phổ biến (PyTorch, Ollama, ComfyUI) hỗ trợ CUDA, nền tảng lập trình GPU của NVIDIA, đầy đủ nhất. Card AMD và chip Apple vẫn chạy được nhiều công cụ, nhưng hay phải cài thêm hoặc thiếu tính năng.
Đọc tiếp
AI Local: chạy LLM và AI tạo ảnh trên máy bạn: chọn GPU theo VRAM, mua hay thuê.
Ollama là gì: chạy chatbot AI trên GPU của bạn, đo 5 model.
Cài Ollama trên Windows, macOS, Linux, Docker: kèm lỗi quên bật GPU trong Docker.
Muốn tự chạy thử các phép đo trong bài mà máy chưa có card rời, AIDev Cloud cho thuê máy RTX 3090 và Tesla P40 theo giờ, có sẵn driver và Docker.
Đo ngày 11/10/2026 trên máy thuê AIDev Cloud ở Hà Nội: RTX 3090 24GB (driver 610.43.02) và Tesla P40 24GB (driver 580.173.02), mỗi máy 25 vCPU Xeon E5-2680 v4, Ubuntu 24.04; PyTorch 2.14.1 (cu130 trên RTX 3090, cu126 trên P40), Ollama 0.40.3, model qwen3.5:9b; máy Mac M4 Pro 48GB với PyTorch 2.14.1 (MPS).
Về tác giả
Founder AIDev
Thạc sĩ AI MSE, tốt nghiệp thủ khoa với điểm 9,4/10. Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên. Sáng lập AIDev và VietPlatform, xây hệ thống AI cho doanh nghiệp. Anh trực tiếp biên soạn và giảng dạy toàn bộ lộ trình AI Engineer.