RTX 3090 cũ chạy AI: card 24GB này có còn đáng mua?

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 15 phút đọc102 lượt xem
Mục lục · 17
Trong ba card mình đo, RTX 3090 cũ là card 24GB nhanh nhất cho LLM và tạo ảnh. Ngày 18/10/2026, các cửa hàng ở Việt Nam bán card này với giá 30 đến 36,5 triệu, bảo hành 1 đến 3 tháng. Mình so tốc độ của card với Tesla P40 và V100 32GB, đo công suất, nhiệt độ khi chạy liền 20 phút. Sau đó mình tính xem dùng bao nhiêu giờ thì mua rẻ hơn thuê.
Có, nếu bạn chạy AI nhiều giờ mỗi tháng. RTX 3090 cũ vẫn có 24GB VRAM, đủ để chạy LLM cỡ 26B đến 35B và tạo video bằng Wan 2.2 14B. Mỗi ảnh SDXL chỉ mất khoảng 6,7 giây. Nhưng ngày 18/10/2026, các cửa hàng ở Việt Nam bán card cũ này với giá 30 đến 36,5 triệu và chỉ bảo hành 1 đến 3 tháng. Nếu tính cả tiền mua phần máy còn lại, bạn phải dùng khoảng 3.250 đến 3.700 giờ thì tổng tiền thuê theo giờ mới bằng tiền mua. Cũng trong ngày này, mình đo song song ba card RTX 3090, Tesla V100 32GB và Tesla P40 để so sánh với nhau.
Những điểm chính của bài:
Với LLM, RTX 3090 nhanh hơn V100 khoảng 1,3 lần và nhanh gấp khoảng 3 lần P40 (với gemma4:26b là 157,8 token/giây, so với 121,7 và 52,6 token/giây).
Khi chạy LLM liền 20 phút, RTX 3090 tiêu thụ trung bình 316W và nóng nhất 67°C. Tốc độ giữ ở khoảng 153 token/giây từ đầu đến cuối. Khi tạo liền 120 ảnh SDXL, card tiêu thụ trung bình 336W và nóng nhất 69°C.
nvidia-smikhông báo nhiệt độ VRAM của RTX 3090 (ghiN/A), trong khi VRAM lại là bộ phận hay nóng nhất trên những card từng dùng để đào coin.Card 24GB không chứa trọn Llama 3.3 70B trên GPU, nên model này chỉ chạy được khoảng 1 token/giây.
Nếu bạn dùng dưới khoảng 100 giờ mỗi tháng, thuê theo giờ sẽ rẻ hơn mua card trong vài năm đầu.
RTX 3090 cũ giá bao nhiêu ở Việt Nam?
RTX 3090 ra mắt năm 2020 và nay gần như không còn hàng mới chính hãng, nên card bán ra lúc này chủ yếu là card cũ. Ngày 18/10/2026, mình xem trang sản phẩm của 4 cửa hàng máy tính. Ba cửa hàng có ghi giá:
Cửa hàng | Mẫu card | Giá niêm yết | Bảo hành |
|---|---|---|---|
Tin học Anh Phát | 6 mẫu của Gigabyte, ASUS, MSI | 36.500.000đ | 3 tháng |
Tin học Anh Phát | ASUS Turbo / Founders Edition | 35.500.000đ / 35.000.000đ | 3 tháng |
Thành Công Computer | ASUS TUF Gaming | 31.000.000đ | 1 tháng |
PC79 | Nhiều hãng, ghi "chưa qua sửa chữa" | 30.000.000đ | 3 tháng (khách mua lẻ) |
Cửa hàng thứ tư ghi "Liên hệ" thay cho giá và bảo hành 1 tháng. Cũng có nơi niêm yết thấp hơn hẳn, khoảng 23 triệu, nhưng mình gọi hỏi thì cửa hàng báo không có hàng. Vì vậy, khi thấy giá rẻ bất thường, bạn nên gọi hỏi xem còn hàng không trước khi đến. Giá cũng thay đổi khá nhanh. Ngày 08/10/2026, mình ghi lại giá trên trang của Tin học Anh Phát là 31.500.000đ cho cùng các mẫu này. Mười ngày sau, giá đã lên 36.500.000đ.

Đây là giá niêm yết trên web, chưa phải giá bạn trả sau khi mặc cả. Nếu mua qua chợ đồ cũ hay nhóm Facebook, giá có thể rẻ hơn nhưng thường không có bảo hành.
24GB VRAM của RTX 3090 chạy được những gì?
Mình đã đo 13 model Ollama trên card này (chi tiết trong bài model Ollama theo VRAM). Kết quả với card 24GB như sau:
Việc cần chạy | Chạy được trên RTX 3090? | Số đo |
|---|---|---|
LLM 26B đến 35B (Gemma 4 26B, Qwen3.6 27B, 35B) | Có, chạy trọn trên GPU | 56 đến 158 token/giây, VRAM 18 đến 22GB |
LLM 70B (Llama 3.3 70B) | Chạy được, nhưng gần một nửa model tràn sang CPU | 0,99 token/giây |
Tạo ảnh SDXL 1024×1024 | Có | 6,67 giây/ảnh, VRAM đỉnh 10,5GB |
Tạo video Wan 2.2 14B (ComfyUI fp8 + LoRA 4 bước) | Có, nhưng gần hết VRAM | 110 giây/clip 5 giây, VRAM đỉnh 23.924MiB |
Wan 2.2 A14B bản gốc | Không | Hết VRAM, repo ghi cần 80GB |
Mình đo SDXL ngày 13/10/2026 và Wan 2.2 ngày 17/10/2026, cả hai trên máy RTX 3090 của AIDev Cloud. Cách mình đo Wan 2.2 có trong bài Wan 2.2 cần bao nhiêu VRAM. Chép ghi âm bằng Whisper thì nhẹ hơn nhiều: bản large-v3-turbo chạy bằng faster-whisper chỉ dùng 2.492MiB VRAM, số đo có ở bài Whisper chạy local.
24GB đủ cho hầu hết các việc của một người tự học hay một nhóm nhỏ đang làm sản phẩm. Card này không chạy nổi model 70B trở lên và các model video bản gốc cần 80GB.
Có một lỗi mình gặp ngay trong đợt đo này. 24GB là dung lượng của cả card, nên mọi chương trình chạy cùng lúc phải chia nhau số VRAM đó. Ollama vừa chạy xong gemma4:26b thì mình bật script tạo ảnh SDXL, và chỉ vài giây sau đã nhận lỗi hết VRAM:
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 20.00 MiB. GPU 0 has a total capacity of 23.56 GiB of which 9.00 MiB is free. Process 39862 has 18.88 GiB memory in use.

Ollama giữ model trong VRAM thêm 5 phút sau lần gọi cuối, nên gemma4:26b vẫn chiếm 18,88 GiB. Sau khi mình gõ ollama stop gemma4:26b, VRAM đang dùng giảm về 1MiB và SDXL chạy bình thường. Nếu bạn định dùng một card cho cả chatbot lẫn tạo ảnh, hãy cộng VRAM của mọi chương trình chạy cùng lúc.
RTX 3090 nhanh hơn P40 và V100 bao nhiêu?
Ba máy dùng cùng image Ubuntu 24.04, cùng 25 vCPU và 53GB RAM, chỉ khác nhau ở card. Mình đo LLM bằng Ollama 0.40.6, context 8.192 token, mỗi lượt sinh 256 token:
Việc cần chạy | RTX 3090 24GB | V100 32GB | P40 24GB |
|---|---|---|---|
gemma4:26b (MoE) | 157,8 token/s | 121,7 | 52,6 |
gpt-oss:20b | 148,6 | 108,6 | 45,5 |
qwen3.5:9b | 76,4 | 64,8 | 29,0 |
qwen3.6:27b (dense) | 56,1 | 43,2 | 18,2 |
qwen3.6:35b | 102,7 | 88,5 | 15,6 (tràn sang CPU) |
SDXL 1024², 25 bước (13/10) | 6,67 s/ảnh | 7,42 | 62,6 (fp32) |
Nhân ma trận fp16 (13/10) | 71,0 TFLOPS | 90,3 | 10,0 |

V100 nhanh hơn ở phép nhân ma trận fp16 thuần, nhưng chậm hơn RTX 3090 ở mọi việc thực tế mình chạy. P40 rẻ nhất nhưng thuộc đời Pascal nên tính fp16 rất chậm. Chạy SDXL ở fp16, mỗi ảnh mất 220 giây; chuyển sang fp32 thì còn 62,6 giây. P40 cũng chỉ dùng được 22,5GB (nvidia-smi báo 23.040MiB), nên Qwen3.6 35B không vừa trọn trên GPU.
Đời card còn quyết định phần mềm có chạy được hay không. Trên máy V100, log của Ollama 0.40.6 cho thấy Ollama bỏ qua bộ thư viện CUDA 13, vì compute capability 7.0 của card không nằm trong danh sách kiến trúc mà bộ này đã biên dịch sẵn:
msg="skipping CUDA device — compute capability not in compiled architectures" device="Tesla V100-PCIE-32GB" cc=700 archs="[750 800 860 870 890 900 1000 1030 1100 1200 1210]"
Ollama vẫn chạy được nhờ bộ CUDA 12 đi kèm. PyTorch thì không tự chuyển sang bản cũ như vậy. Ngày 13/10/2026, mình cài torch bản mặc định (2.14.1+cu130) bằng pip install torch trên máy V100 và nhận ngay lỗi:
Your installed torch==2.14.1+cu130 does not include kernels for this GPU. Reinstall the same version against a CUDA build that does, e.g.:
  For CUDA 12.6 use pip install torch==2.14.1 --index-url https://download.pytorch.org/whl/cu126
torch.AcceleratorError: CUDA error: no kernel image is available for execution on the device
Cài lại bản cu126 thì PyTorch chạy được. P40 cũng gặp đúng lỗi này. RTX 3090 có compute capability 8.6, nằm trong danh sách mà cả Ollama lẫn PyTorch bản mặc định đều hỗ trợ. PyTorch cũng đã thông báo rằng từ bản 2.15 sẽ không còn phát hành bản cài sẵn cho các đời Maxwell, Pascal và Volta, tức là cả P40 lẫn V100. Nếu bạn mua card cũ để dùng thêm vài năm, RTX 3090 an toàn hơn hai card datacenter kia.
Chạy liền 20 phút, RTX 3090 nóng đến đâu và tốn bao nhiêu điện?
Mình cho cả ba card chạy gemma4:26b sinh chữ liên tục trong 20 phút (mỗi lượt 1.024 token, context 8K) và ghi số liệu nvidia-smi mỗi 2 giây:
nvidia-smi --query-gpu=timestamp,power.draw,temperature.gpu,clocks.sm,fan.speed,utilization.gpu,clocks_throttle_reasons.active \
  --format=csv,noheader,nounits -l 2
Card (giới hạn công suất) | Công suất trung bình | Công suất cao nhất | Nhiệt độ 5 phút cuối | Token/s lượt đầu / lượt cuối |
|---|---|---|---|---|
RTX 3090 (350W) | 316W | 332W | 66°C, nóng nhất 67°C | 152,8 / 155,1 |
V100 32GB (250W) | 150W | 182W | 66°C | 114,6 / 110,7 |
P40 (250W) | 156W | 175W | 56°C | 53,5 / 52,7 |

RTX 3090 tốn điện gấp đôi hai card kia và chạm giới hạn công suất gần như suốt bài đo. Trong 591 lần đọc, có 578 lần nvidia-smi ghi lý do hạ xung là 0x0000000000000004 (SW Power Cap, tức card tự giữ công suất dưới 350W). Xung SM vẫn ở mức 1.800 đến 1.995MHz, và không lần nào báo HW Thermal Slowdown. Tốc độ sinh chữ không giảm theo thời gian.
Tạo ảnh thì nặng hơn chạy chatbot. Ngay sau bài đo LLM, mình cho RTX 3090 tạo liền 120 ảnh SDXL 1024×1024 trong 13,5 phút. Công suất trung bình là 336W, cao nhất 349,9W; card nóng nhất 69°C, quạt chạy 56%. Ảnh đầu mất 7,47 giây, các ảnh sau chỉ mất 6,65 đến 6,77 giây. Sau hơn trăm ảnh, tốc độ chênh nhau chưa tới 2%.
Các số này mình đo trên máy thuê đặt trong trung tâm dữ liệu, nơi quạt của card chỉ phải chạy 53 đến 56%. Khi lắp trong thùng máy ở nhà, nhất là vào mùa hè, card có thể nóng hơn. Mình chưa đo card trong thùng máy để bàn nên chưa có số liệu cho trường hợp này.
Mua card cũ cần kiểm tra những gì?
Nhiệt độ VRAM là thứ đáng lo nhất, nhưng nvidia-smi lại không cho bạn xem. Mình chạy nvidia-smi -q -d TEMPERATURE trên ba máy. Đây là kết quả của RTX 3090 và V100:
RTX 3090:
        GPU Current Temp                               : 22 C
        Memory Current Temp                            : N/A
Tesla V100-PCIE-32GB:
        GPU Current Temp                               : 29 C
        Memory Current Temp                            : 28 C

RTX 3090 dùng VRAM GDDR6X, với chip nhớ gắn ở cả hai mặt bo mạch. Tom's Hardware từng ghi nhận VRAM GDDR6X của RTX 3080 và 3090 nóng tới 110°C khi đào Ethereum. Chỉ nhìn bề ngoài thì không biết card cũ từng được dùng vào việc gì, nên hãy hỏi người bán card đã chạy việc gì và trong bao lâu.
Những việc mình sẽ làm khi đi mua:
Hỏi rõ thời hạn và cách bảo hành. Các cửa hàng trong bảng giá bảo hành 1 đến 3 tháng, có nơi cho 1 đổi 1 trong 30 ngày.
Xin chạy thử tại chỗ một việc nặng (LLM hoặc tạo ảnh) trong ít nhất 20 phút như bài đo của mình, để xem card có báo lỗi, bị treo hay chậm dần không.
Kiểm tra bộ nguồn. NVIDIA yêu cầu nguồn tối thiểu 750W cho cả hệ thống khi dùng RTX 3090. Danh sách linh kiện build máy AI mà mình dùng để tính tiền mua ở mục sau thì khuyên dùng nguồn từ 850W trở lên.
Kiểm tra card còn đủ 24GB:
nvidia-smiphải báo 24.576MiB như trên máy của mình.
Mua RTX 3090 cũ hay thuê GPU theo giờ thì rẻ hơn?
Số giờ hòa vốn bằng tiền mua chia cho phần chênh giữa giá thuê và tiền điện mỗi giờ khi tự chạy.
Tiền mua: card 30 triệu (giá thấp nhất trong bảng giá), cộng khoảng 14,9 triệu cho phần máy còn lại. Giá phần này lấy theo danh sách linh kiện build máy AI (CPU, mainboard, 32GB RAM, SSD 1TB, nguồn 850W, vỏ), tổng cộng 570 USD. Số này đổi ra tiền Việt theo giá bán USD của Vietcombank sáng 18/10/2026 (26.080đ).
Tiền điện: card tiêu thụ trung bình 316W khi chạy LLM. Tính theo bậc giá cao nhất 3.460đ/kWh cộng 10% VAT (biểu giá từ 10/5/2025), riêng card tốn khoảng 1.200đ mỗi giờ. Mình chưa đo CPU, RAM và quạt nên không cộng.
Giá thuê: gói RTX 3090 Standard của AIDev Cloud có giá 15.000đ/giờ (25 vCPU, 55GB RAM, 300GB NVMe), giá ngày 18/10/2026.
Tính ra, phải chạy khoảng 3.250 giờ thì tiền thuê mới bằng tiền mua cả bộ. Nếu bạn đã có sẵn máy với nguồn đủ khỏe và chỉ mua thêm card, con số là khoảng 2.170 giờ.
Số giờ dùng GPU mỗi tháng | Hòa vốn khi mua cả bộ (44,9 triệu) | Hòa vốn khi chỉ mua card (30 triệu) |
|---|---|---|
20 giờ | khoảng 163 tháng (13,5 năm) | khoảng 109 tháng |
50 giờ | khoảng 65 tháng | khoảng 43 tháng |
100 giờ | khoảng 33 tháng | khoảng 22 tháng |
200 giờ | khoảng 16 tháng | khoảng 11 tháng |
400 giờ | khoảng 8 tháng | khoảng 5,4 tháng |
Cả ngày lẫn đêm (720 giờ) | khoảng 4,5 tháng | khoảng 3 tháng |

Nếu mua card 36,5 triệu, giá cao nhất trong bảng, cả bộ phải chạy khoảng 3.720 giờ mới hòa vốn. Bảng chưa tính những khoản khiến tự mua tốn hơn: bảo hành chỉ vài tháng, tiền điện của phần máy còn lại, tiếng ồn và hơi nóng trong phòng. Ngược lại, bảng cũng chưa trừ tiền bán lại card sau vài năm.
Ngoài chuyện tiền, thuê theo giờ còn cho bạn đổi card theo việc: LLM nhỏ thì chạy trên P40 giá 7.000đ/giờ, cần context dài với model 31B thì đổi sang V100 32GB, cần chạy trọn Llama 70B trên GPU thì thuê máy 2×RTX 3090 48GB. Nếu bạn dùng dưới khoảng 100 giờ mỗi tháng, thuê GPU theo giờ trên AIDev Cloud sẽ rẻ hơn. Nếu đang định mua, hãy thuê vài giờ để chạy thử đúng việc của mình trước.
Thuê card nào thì mỗi triệu token rẻ nhất?
Mình lấy giá thuê mỗi giờ chia cho số token sinh được mỗi giờ theo tốc độ đo ở trên, không tính thời gian nạp model:
Model | RTX 3090 (15.000đ/giờ) | V100 32GB (20.000đ/giờ) | P40 (7.000đ/giờ) |
|---|---|---|---|
gemma4:26b | khoảng 26.400đ | 45.700đ | 37.000đ |
qwen3.6:27b | 74.300đ | 128.600đ | 106.800đ |
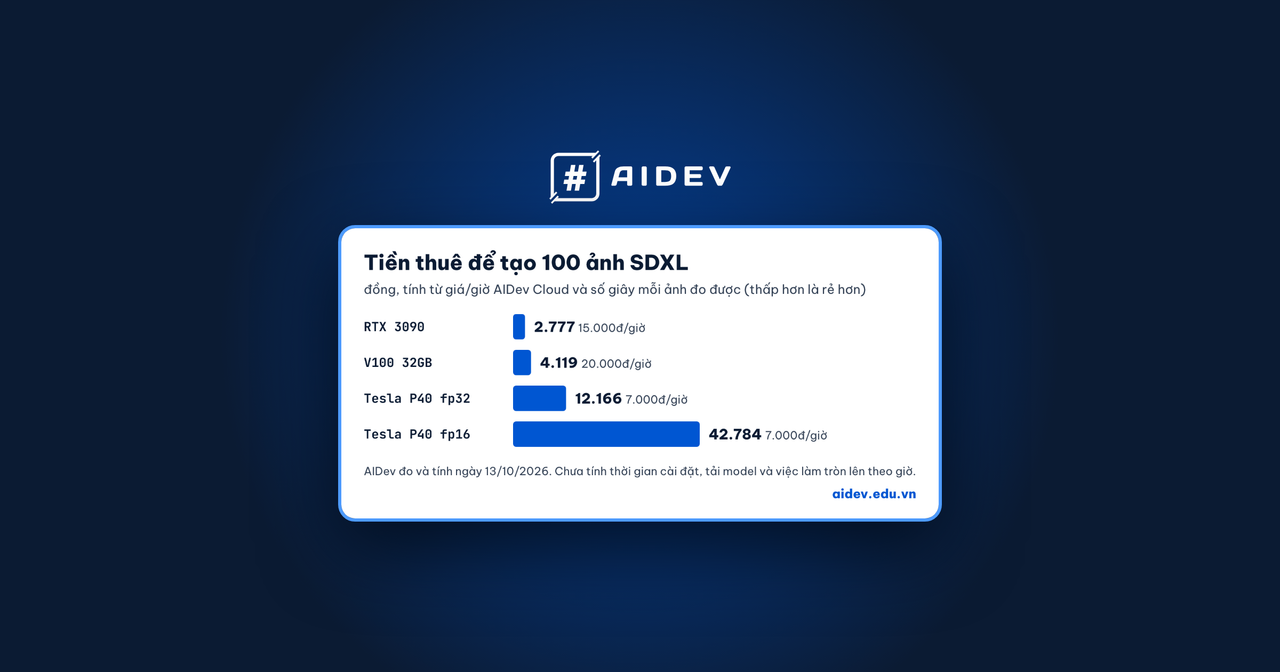
RTX 3090 vừa nhanh nhất vừa rẻ nhất tính trên mỗi token. P40 có giá thuê mỗi giờ thấp nhưng chậm gấp ba, nên tính ra mỗi triệu token lại đắt hơn. P40 chỉ hợp khi bạn cần một máy 24GB cho việc nhẹ, ví dụ thử model hay chạy trợ lý AI cho riêng mình. Bảng giá từng gói và chi phí tạo 100 ảnh SDXL có trong bài giá thuê GPU theo giờ. Các số trên đo bằng Ollama, mỗi lần một request. Khi nhiều người hỏi cùng lúc, bài vLLM là gì đo Qwen3.5-9B trên chính card này: với 16 request cùng lúc, vLLM sinh 1.003 token/giây, khoảng 4đ cho 1.000 token khi máy chạy kín.
Khi nào không nên mua RTX 3090?
Bạn dùng dưới 50 giờ mỗi tháng. Theo bảng ở trên, bạn sẽ mất hơn 5 năm mới hòa vốn, trong khi card này đã ra đời từ năm 2020.
Bạn cần model 70B hay model video bản gốc. 24GB không đủ cho những model này, nên mua một card RTX 3090 không giải quyết được việc đó.
Bạn không có chỗ đặt một máy dùng card 350W chạy nhiều giờ liền. Máy cần nguồn tối thiểu 750W, và bạn phải chịu được hơi nóng cùng tiếng quạt trong phòng.
Người bán không cho chạy thử và chỉ bảo hành vài tuần.
Còn nếu bạn chạy AI gần như cả ngày, ở lâu một chỗ và muốn có máy của riêng mình, RTX 3090 cũ vẫn là card 24GB nhanh nhất trong ba card mình đo.
Câu hỏi thường gặp
RTX 3090 cũ giá bao nhiêu?
Ngày 18/10/2026, giá niêm yết ở 3 cửa hàng máy tính tại Việt Nam là 30 đến 36,5 triệu đồng, kèm bảo hành 1 đến 3 tháng. Có cửa hàng đã tăng giá từ 31,5 lên 36,5 triệu chỉ trong mười ngày, nên bạn hãy hỏi lại giá trước khi đi mua.
RTX 3090 có chạy được Llama 70B không?
Chạy được nhưng rất chậm. File model Llama 3.3 70B nặng 43GB, nên Ollama phải đẩy khoảng một nửa model sang CPU, và tốc độ chỉ còn 0,99 token/giây ở context 8K. Lệnh ollama ps báo model chiếm 45GB ở context 8K, nên muốn chạy trọn trên GPU bạn cần khoảng 48GB VRAM, ví dụ hai card 24GB. Mình chưa chạy thử cấu hình hai card.
RTX 3090 hay Tesla P40 cho người mới học AI?
Hai card cùng có 24GB, nhưng RTX 3090 chạy LLM nhanh gấp khoảng 3 lần và tạo ảnh SDXL nhanh gấp gần 10 lần. P40 tính fp16 rất chậm. PyTorch cũng đã thông báo sẽ ngừng phát hành bản cài sẵn cho đời card này từ bản 2.15. Nếu là mình, mình chọn RTX 3090.
RTX 3090 chạy AI tốn bao nhiêu tiền điện?
Mình đo riêng card và thấy nó tiêu thụ trung bình 316W khi chạy LLM liền 20 phút. Tính theo bậc giá điện cao nhất cộng VAT, riêng card tốn khoảng 1.200đ mỗi giờ. Con số này chưa tính điện của CPU, RAM và quạt.
Mua card hay thuê GPU theo giờ?
Nếu mua cả bộ máy khoảng 44,9 triệu, bạn cần chạy khoảng 3.250 giờ mới hòa vốn so với thuê 15.000đ/giờ. Với 100 giờ mỗi tháng, thời gian hòa vốn là gần 3 năm. Nếu dùng ít hơn mức đó, thuê theo giờ sẽ rẻ hơn.
Đọc tiếp
AI Local: chạy LLM và AI tạo ảnh trên máy bạn: bài tổng quan của chuyên mục, gồm cách chọn card và nên mua hay thuê.
Model Ollama theo VRAM: kết quả đo 13 model trên RTX 3090, V100, P40 và bảng chọn model cho card 8GB đến 48GB.
Giá thuê GPU theo giờ: bảng giá từng gói P40, RTX 3090, V100 và chi phí cho từng việc.
Wan 2.2 cần bao nhiêu VRAM: tạo video AI trên RTX 3090 24GB và những bản nào chạy được.
GPU là gì, vì sao AI cần GPU: giải thích VRAM, băng thông và vì sao GPU chạy AI nhanh hơn CPU.
Chưa chắc có nên mua? Hãy thuê RTX 3090 theo giờ trên AIDev Cloud và chạy đúng model, workflow của bạn trong vài giờ. Khi đã biết card có đủ cho việc của mình hay không, bạn hãy tính chuyện mua.
Mình đo ngày 18/10/2026 trên ba máy AIDev Cloud gói Standard (25 vCPU Xeon E5-2600 v4, 53GB RAM, Ubuntu 24.04): RTX 3090 24GB (driver 610.43.02, CUDA 13.3), Tesla V100-PCIE-32GB và Tesla P40 24GB (driver 580.173.02, CUDA 13.0), Ollama 0.40.6. Số liệu SDXL và nhân ma trận đo ngày 13/10/2026 (diffusers, torch 2.14.1+cu126); số liệu Wan 2.2 đo ngày 17/10/2026 (ComfyUI 0.41.0), cùng trên loại máy RTX 3090 này. Giá card lấy từ web của các cửa hàng ngày 18/10/2026.

Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.