Prompt Stable Diffusion: viết prompt ra ảnh đẹp

AIDev TeamTham vấn chuyên môn: Nguyễn Việt Chung
Đăng 12 phút đọc2 lượt xem
Mục lục · 23
Một Stable Diffusion prompt tốt mô tả chủ thể trước, rồi bối cảnh, ánh sáng, kiểu ảnh. Bài này giữ nguyên seed, chỉ đổi prompt và tạo 34 ảnh trên SDXL và Z-Image-Turbo để xem từng thay đổi tác động ra sao: thêm lớp mô tả, tag hay câu văn, negative prompt, trọng số (từ:1.4), cfg và thứ tự từ.
Cách viết Stable Diffusion prompt mình thấy dễ kiểm soát nhất là mô tả theo lớp: chủ thể trước, sau đó bối cảnh, ánh sáng, cuối cùng là kiểu ảnh và ống kính. Ngày 26/10/2026, mình giữ seed 42, đổi từng phần của prompt và tạo 34 ảnh bằng SDXL và Z-Image-Turbo trên RTX 3090. Chỉ với "a bowl of pho", SDXL vẽ ra tranh minh họa; thêm bối cảnh quán vỉa hè là thành ảnh chụp.
Những điều rút ra từ 34 ảnh:
Prompt ngắn thì model tự chọn phong cách. Mỗi lớp mô tả thêm vào là bớt một chỗ để model đoán.
Viết kiểu tag cách nhau dấu phẩy hay viết câu văn cho kết quả gần như nhau. Viết những chữ gì quan trọng hơn viết theo kiểu nào.
Negative prompt (danh sách thứ không muốn có) không sửa được chuyện model hiểu sai chủ thể, lại có thể làm đổi cả bố cục.
Trọng số
(red lanterns:1.4)tăng đúng thứ mình muốn; đẩy lên 2.0 thì ảnh cháy màu đỏ.Z-Image-Turbo hiểu câu "cầm nón lá bằng hai tay" đúng, SDXL thì không. Chọn model hợp với prompt nhiều khi đáng hơn sửa prompt.
Stable Diffusion prompt gồm những phần nào?
Prompt là đoạn chữ mô tả ảnh muốn tạo. Model như SDXL không đọc chữ trực tiếp: text encoder (bộ mã hóa văn bản) đổi prompt thành dãy số, rồi model khử nhiễu dần theo dãy số đó. Ba thứ khác cũng quyết định ảnh ra sao:
Thành phần | Nó làm gì | Giá trị mình dùng |
|---|---|---|
Prompt (positive) | mô tả thứ muốn có | thay đổi theo từng thí nghiệm |
Negative prompt | mô tả thứ không muốn có |
|
Seed | số khởi tạo nhiễu ban đầu; cùng seed, cùng prompt thì ra cùng ảnh | 42 |
cfg | mức bám prompt; cao thì bám sát hơn nhưng dễ cháy màu | 7 với SDXL, 1 với Z-Image-Turbo |
Khi thử prompt, mình luôn giữ seed cố định. Seed đổi thì ảnh đổi, và bạn sẽ không biết thay đổi đến từ prompt hay từ seed. Mọi ảnh trong bài dùng seed 42, trừ phần thử seed.
Hai model mình dùng có text encoder khác hẳn nhau. SDXL base 1.0 dùng hai bộ CLIP (OpenCLIP-ViT/G và CLIP-ViT/L, theo model card). Z-Image-Turbo dùng qwen_3_4b, một LLM (mô hình ngôn ngữ lớn) cỡ nhỏ, làm text encoder. Khác biệt này giải thích vài kết quả trong các phần thử tiếp theo.
Cách mình thử: cùng seed, chỉ đổi prompt
Mình chạy ComfyUI 0.42.1 trên máy Windows có RTX 3090 (cách cài ở bài cài ComfyUI Portable trên Windows). Thay vì bấm Run 34 lần, mình gửi workflow qua API của ComfyUI bằng một script Python ngắn. Phần chính của script:
def chay(wf):
    body = json.dumps({"prompt": wf, "client_id": str(uuid.uuid4())}).encode()
    req = urllib.request.Request(API + "/prompt", body, {"Content-Type": "application/json"})
    pid = json.load(urllib.request.urlopen(req))["prompt_id"]
    while True:                      # chờ ComfyUI chạy xong rồi đọc thời gian trong /history
        time.sleep(0.5)
        h = json.load(urllib.request.urlopen(f"{API}/history/{pid}"))
        if pid in h and h[pid]["status"].get("completed") is not None:
            return h[pid]
Mỗi thí nghiệm là một dòng trong file JSON, chỉ khác nhau ở prompt, negative hoặc cfg:
{"ten": "D-sdxl-w14", "model": "sdxl", "seed": 42, "neg": "blurry, lowres",
 "pos": "a street in Hoi An at night with (red lanterns:1.4) and people walking, photo"}
SDXL chạy 1024×1024, 25 bước, sampler dpmpp_2m, scheduler karras. Z-Image-Turbo chạy 1024×1024, 8 bước, cfg 1, theo workflow mẫu của ComfyUI. Cả 34 ảnh mất 398 giây; thời gian theo từng model ở mục "Tạo mỗi ảnh mất bao lâu?".
Prompt cần chi tiết đến đâu?
Mình bắt đầu từ "a bowl of pho" rồi thêm từng lớp. Mỗi lớp giữ nguyên chữ của lớp trước:
1. a bowl of pho
2. a bowl of pho on a small plastic table at a Hanoi street stall
3. ... , early morning light, steam rising from the broth
4. ... , photo, 35mm lens, shallow depth of field, detailed

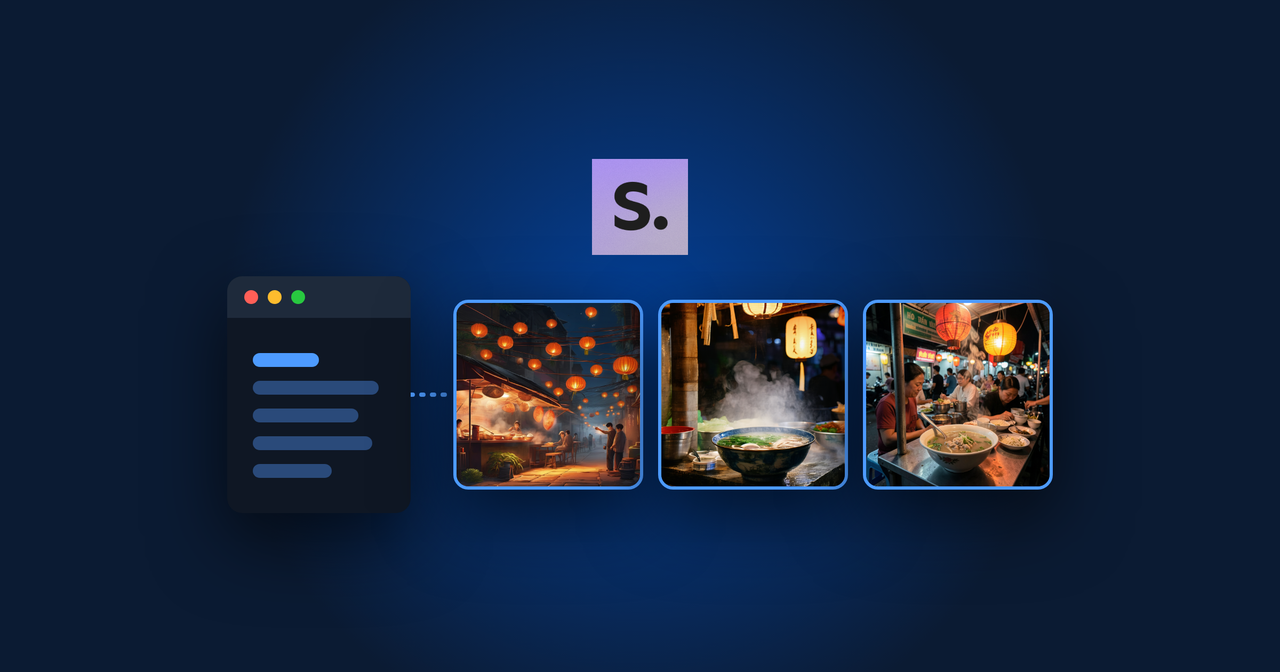
Với SDXL, "a bowl of pho" cho ra tranh minh họa nhìn từ trên xuống. Thêm bối cảnh quán vỉa hè, model chuyển sang ảnh chụp đường phố. Lớp ánh sáng thêm hơi nước và nắng xiên. Lớp cuối (35mm, xóa phông) kéo máy ảnh lại gần bát phở, phông sau mờ hẳn.
Z-Image-Turbo phản ứng khác. Ngay lớp 1 đã ra ảnh chụp, có lẽ vì model được huấn luyện thiên về ảnh thật. Từ lớp 2 trở đi, bố cục gần như đứng yên: bát phở trên một chiếc ghế nhựa, khói rõ hẳn từ lớp 3. Lớp 4 giữ nguyên bố cục, chỉ đổi màu bát, tức là với model này mấy chữ về ống kính ít tác dụng.
Thứ tự mình dùng khi viết prompt mới:
[chủ thể] + [bối cảnh, nơi chốn] + [ánh sáng, thời điểm] + [kiểu ảnh, ống kính, chất lượng]
Viết prompt kiểu tag hay câu văn?
Nhiều prompt chia sẻ trên mạng viết kiểu tag, các cụm cách nhau dấu phẩy. Z-Image-Turbo dùng LLM làm text encoder nên mình muốn xem nó có hợp với câu văn hơn không. Mình viết cùng một nội dung theo hai kiểu:
tag : pho, bowl, plastic table, Hanoi street stall, morning light, steam, photo, 35mm, shallow depth of field
câu : A photo of a steaming bowl of pho on a small plastic table at a Hanoi street stall in the early morning,
      shot on a 35mm lens with shallow depth of field.

Hai kiểu cho ảnh gần giống nhau trên cả hai model. SDXL vẫn ra quầy phở có người nấu, Z-Image-Turbo vẫn ra bát phở trắng trên bàn. Với prompt mô tả cảnh đơn giản thế này, mình không thấy lý do phải đổi thói quen. Khác biệt giữa hai model lộ rõ hơn khi câu có quan hệ giữa các vật, như ở phần negative prompt tiếp theo.
Negative prompt có tác dụng gì?
Negative prompt đẩy ảnh ra xa những gì bạn liệt kê. Nhiều người chép một danh sách dài kiểu bad anatomy, extra fingers để sửa tay chân. Mình thử với một prompt có chi tiết về tay:
prompt   : portrait of an elderly Vietnamese street vendor woman holding a conical hat with both hands, photo
negative : (trống)  |  blurry, lowres  |  blurry, lowres, bad anatomy, extra fingers, deformed hands,
           watermark, text, cartoon, painting

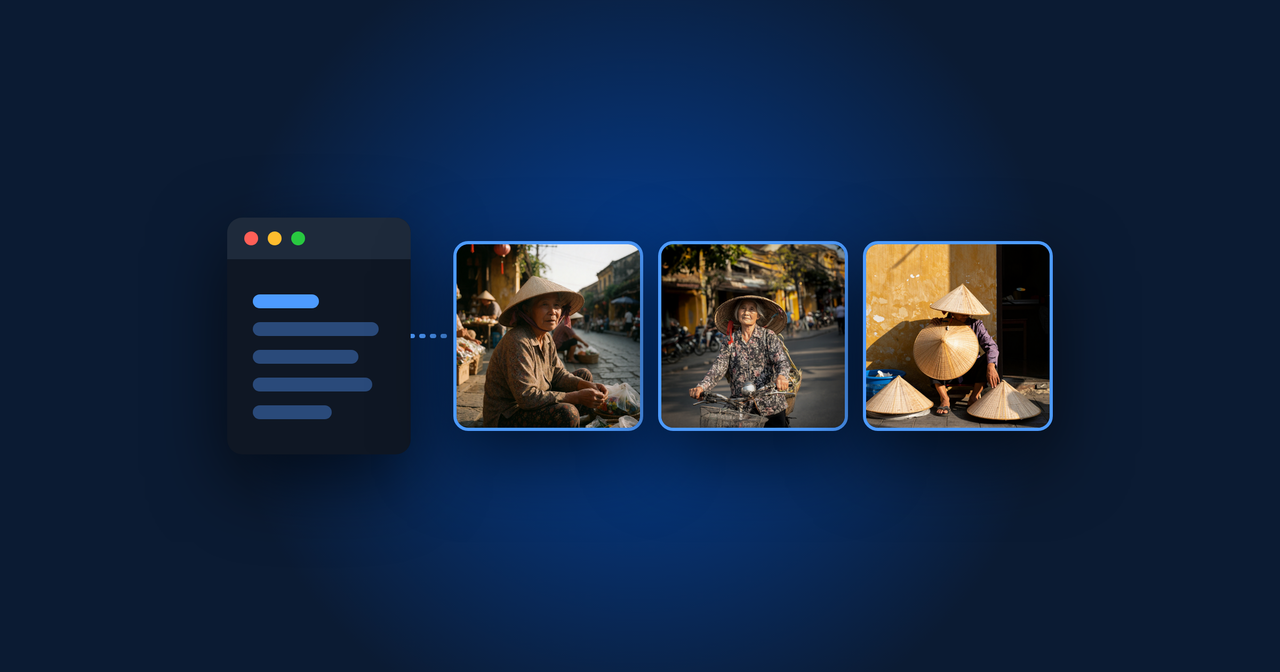
Cả ba ảnh SDXL đều hiểu sai: bà cụ đội nón và cầm một cái rổ tre trong khi prompt muốn bà cầm nón bằng hai tay. Thêm negative prompt cũng không sửa được. Nó còn làm đổi bố cục: với blurry, lowres, chiếc nón biến thành cái nia che kín mặt. Z-Image-Turbo hiểu đúng ngay từ đầu, bà cụ cầm chiếc nón lá trước ngực bằng hai tay.
Ảnh Z-Image-Turbo chạy cfg 1. Ở cfg 1, phép tính cfg chỉ còn phần prompt, nên negative prompt không có tác dụng gì; workflow mẫu của ComfyUI cũng thay negative bằng node ConditioningZeroOut. Muốn dùng negative với model turbo phải tăng cfg, và theo công thức thì thời gian mỗi ảnh sẽ tăng (mình chưa đo phần này).
Trọng số (từ:1.4) dùng thế nào?
ComfyUI cho đặt trọng số bằng ngoặc: (good code:1.2) nhấn mạnh hơn, (bad code:0.8) nhấn nhẹ đi; ngoặc không ghi số mặc định là 1.1 (README của ComfyUI). Mình đổi trọng số của cụm "red lanterns" trên SDXL:
a street in Hoi An at night with (red lanterns:0.6) and people walking, photo
a street in Hoi An at night with red lanterns and people walking, photo
a street in Hoi An at night with (red lanterns:1.4) and people walking, photo
a street in Hoi An at night with (red lanterns:2.0) and people walking, photo

Ở 0.6, ảnh gần như không khác bản không ghi trọng số. Ở 1.4, đèn dày hơn mà con phố vẫn giữ nguyên. Đến 2.0, màu đỏ tràn khắp khung hình, mặt đường ánh đỏ, bố cục đổi hẳn sang một quảng trường đông người. Mình giữ trọng số trong khoảng 0.8 đến 1.4; trong lần thử này, mức 2.0 đã cháy màu.
Cú pháp ngoặc do ComfyUI và các giao diện như AUTOMATIC1111 (A1111) xử lý trước khi gửi cho model. Gửi prompt có ngoặc qua một dịch vụ khác, ngoặc có thể bị hiểu là chữ thường.
cfg cao hay thấp thì ảnh đẹp hơn?
cfg (classifier-free guidance) quyết định ảnh bám prompt chặt đến đâu. Mình giữ prompt lớp 4 (bát phở quán vỉa hè) và chỉ đổi cfg của SDXL:

cfg 3 cho ảnh nhạt và rộng, gần với cảnh của lớp 2 hơn là lớp 4. cfg 7 và 12 bám prompt tốt, 12 tương phản mạnh hơn. cfg 20 bão hòa màu, mảng xanh đỏ gắt như ảnh chỉnh quá tay. Với SDXL, mình dùng 5 đến 8. Model turbo như Z-Image-Turbo thì để cfg 1 như workflow mẫu.
Thứ tự chữ trong prompt có quan trọng không?
Có. Mình đặt cụm "red bicycle" ở đầu rồi ở cuối prompt, còn lại giữ nguyên:
red bicycle, a quiet alley in Hanoi with yellow walls and potted plants, photo
a quiet alley in Hanoi with yellow walls and potted plants, photo, red bicycle

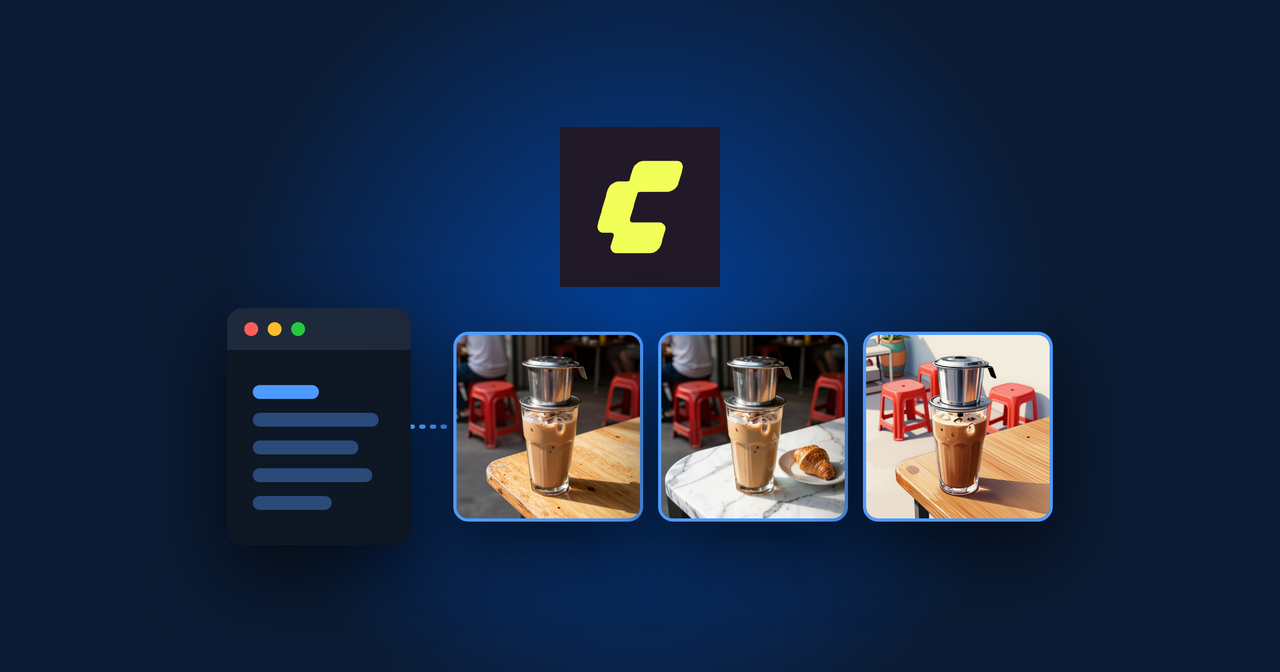
Đặt đầu, chiếc xe đạp thành chủ thể chiếm giữa khung. Đặt cuối, nó lùi thành một chi tiết bên cạnh con ngõ. Trong lần thử này, SDXL ưu tiên cụm đứng trước, nên mình luôn đặt chủ thể lên đầu prompt.
Đổi seed thì ảnh khác đến đâu?
Cùng prompt lớp 4, mình chỉ đổi seed từ 1 đến 4:

SDXL cho bốn bố cục khác nhau, tức là đổi seed là cách nhanh để có thêm lựa chọn. Z-Image-Turbo cho bốn ảnh gần như cùng bố cục, chỉ khác màu ghế và lát thịt. Với model này, muốn ảnh khác thì phải đổi prompt chứ đổi seed ít tác dụng.
Lỗi mình gặp khi viết prompt và chạy thử
1. Prompt có quan hệ giữa các vật bị SDXL hiểu sai
portrait of an elderly Vietnamese street vendor woman holding a conical hat with both hands, photo
SDXL ra bà cụ đội nón, cầm rổ, cả khi thêm negative prompt. Mình thử đổi model chứ không sửa prompt: Z-Image-Turbo vẽ đúng ngay lần đầu. Nếu buộc phải dùng SDXL, tách ý ra cho dễ hiểu hơn, ví dụ bỏ "with both hands" và đặt "conical hat" lên đầu prompt (mình chưa thử cách này).
2. Trọng số quá cao làm hỏng cả ảnh
a street in Hoi An at night with (red lanterns:2.0) and people walking, photo
Muốn thêm đèn lồng mà ảnh đổi luôn bố cục và cháy đỏ. Hạ về 1.4 là vừa.
3. SyntaxWarning: invalid escape sequence '\p' khi chạy script trên Windows
C:\AI\do_prompt.py:2: SyntaxWarning: invalid escape sequence '\p'
  Dung: python_embeded\python.exe do_prompt.py thi_nghiem.json"""
Python 3.13 cảnh báo vì chuỗi ghi chú của script có đường dẫn Windows python_embeded\python.exe, trong đó \p bị hiểu là ký tự đặc biệt. Script vẫn chạy hết 34 ảnh. Cách sửa: viết đường dẫn bằng dấu / hoặc thêm chữ r trước chuỗi (r"""...""").
Tạo mỗi ảnh mất bao lâu?
Thời gian lấy từ /history của ComfyUI cho 34 ảnh:
Model | Số ảnh | Ảnh thường | Ảnh đầu tiên hoặc ngay sau khi đổi model |
|---|---|---|---|
SDXL base 1.0 (25 bước) | 23 | 9,30 đến 10,10 giây, trung bình 9,74 | 18,84 đến 21,07 giây |
Z-Image-Turbo (8 bước) | 11 | 7,70 đến 8,39 giây, trung bình 7,92 | 17,18 đến 18,33 giây |
Mỗi lần chuyển qua lại giữa hai model, ComfyUI phải nạp lại model nên mất khoảng gấp đôi. Khi thử prompt, nên chạy hết các ảnh của một model rồi mới sang model kia. Cả 34 ảnh mất 398 giây, với giá máy 15.000đ mỗi giờ thì khoảng 1.700đ tiền máy (số tính từ thời gian chạy, chưa tính lúc chờ).
Khi nào không cần mất công viết prompt kỹ?
Bạn chỉ cần ảnh minh họa chung chung, chọn một trong vài seed là đủ.
Dùng model turbo như Z-Image-Turbo cho ảnh chụp: prompt hai lớp (chủ thể + bối cảnh) đã ra ảnh tốt, thêm chữ về ống kính ít khác biệt.
Việc cần bố cục chính xác (vị trí, tư thế cụ thể): chữ không đủ, nên dùng ảnh tham chiếu hoặc custom node điều khiển bố cục. Cài custom node xem bài ComfyUI Manager.
Câu hỏi thường gặp
Viết Stable Diffusion prompt bằng tiếng Việt được không?
Được với vài model mới, nhưng kết quả kém ổn định hơn tiếng Anh. Bài ComfyUI là gì có phần thử prompt tiếng Việt trên SDXL và ba model mới hơn. Tên riêng như "pho", "Hoi An", "Hanoi" thì model hiểu tốt dù viết không dấu.
Prompt dài bao nhiêu là vừa?
Prompt dài nhất trong bài khoảng 30 chữ và vẫn ra đúng ý. Viết dài hơn mà mỗi chữ không thêm thông tin thì chỉ làm loãng phần quan trọng. Thêm từng lớp rồi xem ảnh đổi gì, lớp nào không làm ảnh đổi thì bỏ.
Có cần negative prompt dài không?
Với SDXL, mình dùng blurry, lowres là đủ. Danh sách dài không sửa được lỗi hiểu sai chủ thể, còn có thể làm đổi bố cục như ảnh bà cụ ở trên. Với model turbo chạy cfg 1, negative prompt không có tác dụng.
Cùng prompt, cùng seed có luôn ra cùng ảnh không?
Trên cùng máy, cùng model, cùng thiết lập thì có. Khác card GPU hoặc khác phiên bản PyTorch có thể ra ảnh hơi khác. Mình chưa so ảnh cùng seed giữa hai máy khác nhau.
Đọc tiếp
AI Local: chạy LLM và AI tạo ảnh trên máy bạn: bài tổng quan của chuyên mục.
Stable Diffusion là gì: sáu model, thời gian và VRAM từng model.
Stable Diffusion miễn phí: chạy online, Colab hay GPU thuê.
Cài ComfyUI Portable trên Windows: cài từ file .7z đến ảnh đầu tiên.
Muốn tự thử prompt với SDXL và Z-Image-Turbo mà máy chưa có card 24GB, bạn có thể thuê GPU RTX 3090 theo giờ trên AIDev Cloud, chạy một loạt prompt như trên rồi trả máy.
Chạy ngày 26/10/2026 trên máy AIDev Cloud RTX 3090 24GB gói Standard, image Windows 10 AI (Windows 10 IoT Enterprise LTSC 21H2), driver NVIDIA 610.62. ComfyUI Portable 0.42.1, Python 3.13.14, PyTorch 2.14.0+cu130. Model SDXL base 1.0 (sd_xl_base_1.0.safetensors) và Z-Image-Turbo bf16 (repo Hugging Face Comfy-Org/Z-Image-Turbo, tên cũ z_image_turbo).
Chuyên mục
AI Local
Tham vấn chuyên môn
Nhà sáng lập AIDev và VietPlatform · Thạc sĩ AI MSE
- Tốt nghiệp thủ khoa xuất sắc Thạc sĩ AI MSE.
- Đồng sáng lập, CTO E-University, SVOnline: số hóa 10+ đại học, 40.000+ sinh viên.
- Xây hệ thống AI cho doanh nghiệp tại VietPlatform.